❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
🔲 ☆

MacSpace - Nettoyez ce qui se cache dans les données système de votre Mac

Si vous avez jeté un œil au stockage de votre Mac sous macOS 27 récemment, vous avez forcément croisé ce gros bloc "Données système" que Réglages Système ne vous explique jamais vraiment en détail.

Mais c'était sans compter sur MacSpace , une appli libre qui s'attaque justement à ce truc-là, et qui s'occupe également au passage des modèles d'Apple Intelligence histoire de gagner un peu de place.

En réalité, "Données système" n'est pas un dossier mais tout le bordel et l'espace dont macOS a besoin. Mais quand on creuse un peu, on peut découvrir grâce à MacSpace à quoi tout ceci correspond dans le détail.

Données système ventilé par catégorie, avec l'historique des versions marqué Irréversible

Le bouton "Libérer" supprimera alors ce qui ne craint pas. Je pense aux caches des applications fermées, les rapports de diagnostic et de plantage datés de plus de 7 jours, et les ressources système inutilisées. De son côté, l'historique des versions de vos documents a son propre bouton, marqué "Irréversible" puisque les anciennes versions partent pour de bon. En effet, n'espérez pas retrouver ce que vous avez supprimé avec MacSpace dans la corbeille.

Notez bien que pour ces ressources système, comme pour les fichiers marqués purgeables et les modèles d'IA, ce n'est pas MacSpace qui s'occupe de la suppression. L'app confie ce travail à CacheDelete, l'outil de purge que macOS lance lui-même quand le disque est presque plein, sans toutefois indiquer quels fichiers il emporte. Mais bon, vous ne prendrez pas grand risque puisque ces fichiers se téléchargeront ou se créeront à nouveau s'ils redeviennent nécessaires, et MacSpace ne touchera bien sûr jamais à vos documents, à Photos, à Mail ni à Messages.

Le module "Autres fichiers système" retirera aussi du Mac les copies locales de vos fichiers OneDrive ou iCloud Drive, qui resteront dans le cloud et reviendront dès que vous les ouvrirez.

Et puis il y a Apple Intelligence dont je vous parlais il y a quelques jours avec l'outil RemoveMacAI , qui supprime les modèles restés sur le disque et bloque leur retour avec un profil renvoyant leurs téléchargements vers un port local fermé. Hé bien MacSpace passe par une autre porte puisqu'il règle Siri sur une langue différente de celle du Mac, ce qui suffit à macOS pour décider qu'Apple Intelligence n'est pas dispo. MacSpace peut alors purger les modèles, qui peuvent peser 12 Go si pas plus.

Attention quand même, ça veut dire que Siri ne vous parlera plus dans la langue de votre Mac. Et avec la synchronisation iCloud de Siri activée, ce changement de langue débarquera aussi sur votre iPhone et votre iPad. MacSpace vous prévient bien sûr et vous montre comment couper cette synchro. Pour revenir en arrière, il suffit après de rebasculer l'interrupteur pour retrouver votre langue et votre voix Siri d'origine (macOS pourra alors retélécharger les modèles).

Le dernier module, Debloat, aligne 14 switchs pour couper la télémétrie, les publicités personnalisées, Siri AI ou l'indexation de vos données par Apple Intelligence, dont 6 via un profil de configuration à approuver une fois. Et comme macOS rallume certains réglages tout seul (l'identifiant publicitaire revient à peu près chaque jour, d'après le développeur), MacSpace vérifie toutes les 15 minutes tant qu'il tourne et coupe à nouveau ce que macOS a rallumé, hors règles du profil.

Les switchs de Debloat et le bouton "Tout activer"

Pour réussir à faire tout ça, MacSpace installe un daemon système qui n'exécute que des opérations inscrites dans son code et n'accepte que des clients signés par la même équipe. L'app n'a aucune télémétrie, et ne se sert du réseau que pour ses mises à jour.

Côté config, il vous faut évidemment un Mac Apple Silicon sous macOS 27. C'est gratos, sous licence MIT, dispo en français, et ça s'installe soit en DMG, soit via Homebrew comme ceci :

brew install --cask 1architect/macspace/macspace

Dernier détail, il n'y a pas de désinstalleur donc avant de virer l'app, appuyez sur "Tout activer" dans Debloat et rallumez Apple Intelligence si vous l'aviez coupé, sinon les réglages modifiés resteront en place.

Source : MacSpace sur GitHub

🔲 ☆

J'ai testé les 12 clones gratuits d'Adobe et de Microsoft

Depuis quelques jours c'est l'effervescence sur le net car l'équipe d'ArtCraft a mis en ligne sur GitHub, 12 logiciels GRATUITS qui ont pour mission de remplacer TOUS les outils payants que nous sommes très nombreux à utiliser.

Ces nouveaux logiciels s'appellent PhotoCraft, VectorCraft, FilmCraft, LightCraft, PdfCraft, EffectCraft, DesignCraft, WordCraft, SoundCraft, DeckCraft, CADCraft et GridCraft. Et ces Crafting Apps sont des réécritures "propres" en Rust et natives pour macOS, Windows et Linux d'incontournables comme Adobe Photoshop, Microsoft Word, Avid Pro Tools ou encore Autodesk AutoCAD.

Maintenant pour réussir à publier 12 clones d'outils aussi iconiques en quelques jours, l'équipe derrière le projet ne s'est évidemment pas tapé tout à la main, vous vous en doutez... De nombreux commits de PhotoCraft sont par exemple co-signés "Claude Opus 3.5" ou "Codex". Hé oui, les ravages de l'IA qui a reçu pour consigne de refaire à l'identique par exemple Photoshop avec les mêmes menus, les mêmes raccourcis, et le même comportement.

J'ai mis un peu de temps à me décider d'installer tout ça pour tester parce que tous ces outils, depuis que l'IA est entrée dans ma vie, bah je n'en ai plus vraiment besoin. Mais bon, faut bien que je fasse mon taf à un moment ou à un autre ^^ alors j'ai pris le temps de tout installer sur mon Mac pour voir ce que ça donne...

Déjà l'installation passe par l'ArtCraft Launcher, signé par une société nommée Learning Machines LLC , qui installe chaque app en quelques secondes depuis les releases GitHub, après avoir contrôlé son empreinte SHA-256. Au total, en installant tout, j'ai fini avec 1,7 Go d'applications, ce qui est vraiment peu, je trouve.

Voici à quoi ressemble ce launcher :

Le launcher en vue tableau, avec sa colonne "Inspirée de" et la mention des marques en bas

J'ai donc commencé par PhotoCraft en ouvrant le PSD de mon propre logo, soit 7 calques et tous se sont bien chargés, même les calques techniques comme ceux concernant la lumière, la densité des couleurs, etc. En plus, j'ai été surpris mais l'interface est entièrement en français, avec des menus identiques à ceux qu'on retrouve sur Photoshop jusqu'au "Filtre Camera Raw". J'ai ensuite comparé le rendu de l'outil à l'image fusionnée que Photoshop avait enregistrée dans le fichier, et 100 % des pixels correspondent. Et quand je réenregistre en PSD mon fichier, celui-ci garde ses sept calques et se rouvre à l'identique.

C'est assez impressionnant, je suis bluffé...

Mon logo PSD dans PhotoCraft, avec ses sept calques et leurs modes de fusion

WordCraft, lui, reprend le menu "ruban" de Word jusqu'aux onglets Mailings et Zotero, et mon document de test (avec titres, gras, italique, accents, liste et tableau) s'affiche impecc. Par contre, l'interface reste en anglais et le correcteur souligne tout mon french en rouge par défaut.

WordCraft et mon document de test, sous un ruban calqué sur celui de Word

De son côté, le tableur GridCraft, quant à lui, a passé une épreuve un peu plus dure puisque dans mon classeur j'ai enregistré des formules SUM, AVERAGE et MAX mais sans leur résultat. Hé bien lui les a recalculées de lui-même sans une erreur !

GridCraft a recalculé seul les totaux, la moyenne et le maximum de mon classeur

Pour le reste, PdfCraft a parfaitement lu mon PDF de trois pages, VectorCraft a affiché correctement un SVG avec courbes et texte s'il vous plait, DeckCraft a affiché mes trois diapos PowerPoint de test, et CADCraft respecte totalement les proportions d'un plan DXF.

CADCraft et mon plan DXF, avec un ViewCube et une ligne de commande façon AutoCAD

De son côté, DesignCraft (le clone InDesign) sait ouvrir un fichier IDML sur 2 colonnes, césure comprise, en signalant les erreurs et les polices manquantes. Enfin, pour l'image et le son, LightCraft permet d'importer un dossier de JPEG, SoundCraft charge un WAV stéréo dans la joie et la bonne humeur, et FilmCraft tout comme EffectCraft importent des vidéo MP4 sans problème (j'ai testé uniquement avec des vidéos de quelques secondes.)

Les 6 autres apps que j'ai lancé en test avec les fichiers de l'essai, et entre parenthèses le logiciel dont chacune s'inspire

Attention quand même, tout ce que j'ai ouvert là, ce sont des formats qui ont été documentés publiquement. Si vous essayez d'ouvrir des projets After Effects et Premiere, ça ne passera pas. EffectCraft ne sait pas ouvrir les .aep, et FilmCraft ne lit pas encore les .prproj. Après SoundCraft n'échange encore aucune session en AAF ou en OMF, et CADCraft perd à l'enregistrement les entités qu'il ne gère pas.

Voilà, donc si le format proprio PSD passe aussi bien, c'est parce qu'Adobe en a publié les specs depuis longtemps.

Voilà pour mon petit test... Ce que je peux vous dire c'est que le boulot accompli est vraiment impressionnant, mais que les outils sont assez inégaux dans leur maturité. Après rien d'inquiétant car ça avance très très vite entre les contributions et l'IA. Donc pour le moment, ça ne remplacera pas Photoshop si vous êtes un pro de cet outil. Mais pour des gens comme moi qui en ont un usage très ponctuel, c'est le pied !

FilmCraft, son projet de démo et ma vidéo de test importée en bas à gauche

Maintenant, la question que je me suis posé, c'est qui finance tout ce bordel ?

Parce que même si c'est l'IA qui fait en grande partie le taf, faut bien payer les tokens ! Et bien, derrière le projet, il y a Brandon Thomas, qui se présente sur GitHub comme fondateur d'ArtCraft, de Storyteller.ai et de FakeYou. FakeYou, c'est un site de voix synthétiques de célébrités, sur lequel le Garante italien (la CNIL italienne, quoi...) avait ouvert une enquête en 2022. Et visiblement c'est soutenu par le fonds Pebblebed qui liste ArtCraft dans son portefeuille . Bref, après le clonage de voix, on dirait bien que Brandon est passé au clonage de logiciels. Le garçon a de la suite dans les idées...

Maintenant la thune générée par ArtCraft, provient de leur studio d'images et de vidéos par IA avec des abonnements qui coûtent entre 96 et 576 dollars par an. Cela donne droit à des crédits de génération sur Nano Banana, Seedance ou Kling. Mais rassurez-vous, les Crafting Apps, elles, ne sont pas monétisées.

Maintenant mettre tous ces clones en open source, c'est une excellente idée je trouve car d'un point de vue "code", ça les rend immortels (suffit de cloner le dépôt) et surtout, les contributeurs qui apportent des fonctionnalités et des corrections de bug le font avec leur temps et... leurs tokens... Bah oui.

Donc quelque part, la communauté ArtCraft finance aussi une bonne partie du dev...

Reste la question du droit d'auteur bien sûr puisque concernant le code, le droit européen est très clair. En effet la directive de 2009 sur les logiciels protège ce qui est écrit, mais pas les idées qui se cachent derrière une interface, et elle laisse donc à quiconque le droit d'utiliser un programme, et de le décortiquer en le faisant tourner pour l'analyser. De plus, en 2012, l'arrêt SAS Institute a précisé que ce que fait un logiciel et le format de ses fichiers ne sont pas protégés. Et comme ArtCraft affirme n'utiliser ni code, ni shaders, ni assets propriétaires, ils sont clean, sauf si Microsoft ou Adobe arrivent à prouver le contraire.

Là où ça peut coincer, je pense, c'est au niveau de l'interface puisque fin 2010, la même Cour a estimé qu'une interface graphique , à défaut d'être protégée comme du code, peut l'être comme n'importe quelle œuvre, dès lors qu'elle est originale ! Or chez ArtCraft, il est dit qu'ils ont étudié Photoshop pour son comportement et son apparence et rien d'autre... Oui, son apparence... donc là y'a peut-être une faille ?

Bref, pour le moment rien n'indique que le code viole le droit d'auteur, mais l'interface et la manière de se présenter sont risquées.

Maintenant si vous voulez vous faire votre propre avis, rendez-vous sur getartcraft.com .

🔲 ☆

ONLYOFFICE 10 - L'IA partout, mais seulement si vous la voulez

-- En partenariat avec ONLYOFFICE --

ONLYOFFICE, je vous en ai déjà parlé à plusieurs reprises . Il s'agit de cette suite bureautique open source incroyable du genre Microsoft 365 ou Google Workspace, avec traitement de texte, tableur, présentations et éditeur PDF, à utiliser soit directement dans leur cloud ou à installer sur votre propre serveur !!

Et, youpi, sa version 10.0 débarque avec une 50aine de nouveautés et plus de 1 000 bugs corrigés ! Rien que ça !

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

La grosse nouveauté, vous vous en doutez, c'est bien sûr l'IA, qui arrive dans les 4 outils sous la forme d'un seul onglet dédié avec un chat intégré. Vous pouvez ainsi lui demander au choix de rédiger du texte pour vous, de résumer ce que vous avez la flemme de relire mais également de traduire dans la langue de votre choix, de corriger vos erreurs de grammaire et d'orthographe ou encore de mettre en forme directement votre contenu.

Et comme cette IA tient compte du contexte du document, vous pouvez lui poser des questions par exemple sur un looong PDF, lui faire générer et expliquer une formule un peu compliquée dans le tableur, ou transformer une simple idée en keynote de 2h pour votre prochain TEDx ^^, notes du présentateur comprises.

Dans l'éditeur PDF, le chat IA propose ses requêtes toutes prêtes : résumer, traduire, corriger, créer une table des matières

Cette fonctionnalité IA embarque aussi plusieurs prompts tout faits qui couvrent les demandes les plus courantes. Mais vous pouvez aussi enregistrer les vôtres pour les rejouer d'un clic plus tard, créer des actions rapides pour un besoin ponctuel (du genre changer le ton d'un texte, par exemple) ou vous monter un super assistant qui travaillera en continu pendant que vous chillez à la machine à café et qui réagira à vos modifs pendant que vous écrivez.

Notez que ces deux dernières fonctionnalités ne sont pas encore disponibles pour l'instant, ailleurs que dans le traitement de texte.

La création d'un assistant IA dans le traitement de texte, ici avec un prompt qui extrait décisions et actions d'un compte rendu de réunion

Maintenant, la question que vous vous posez sûrement, c'est où partent vos documents ?

Eh bien ça dépend de la façon dont vous utilisez ONLYOFFICE. Si vous l'utilisez dans le cloud, le service ONLYOFFICE AI repose sur OpenRouter et il faut donc recharger votre wallet pour l'activer (ouaip, c'est payant). Par contre, sur votre serveur à vous, il suffit de brancher le modèle que vous voulez, y compris un modèle qui tourne en local, et dans ce cas, vos documents ne quitteront pas votre infra.

Quoiqu'il en soit, dans les deux cas, c'est vous qui choisissez le modèle par défaut que vous voulez utiliser et bien sûr, attribuer d'autres modèles secondaires à d'autres tâches précises.

Et si l'IA vous donne des boutons, sachez qu'ONLYOFFICE a écouté les retours de ses utilisateurs et l'a totalement retirée des versions open source. Donc si vous êtes en mode open source et que vous voulez de l'IA, faudra l'installer en plus (mais ça reste possible). Desktop Community, la version libre de l'application de bureau, la propose ainsi en module complémentaire facultatif, que vous n'ajoutez que si vous en avez envie.

Cette 10.0 introduit aussi des applications gratuites sous licence AGPL v3, que vous activez selon vos besoins : Des agents IA qui automatisent votre espace de travail avec de la recherche intelligente, une base de connaissances personnalisée avec des serveurs MCP, des formulaires de collecte des données suivi d'une analyse des réponses, un système de fichiers qui centralise le stockage et les droits d'accès, et des espaces de collaboration sécurisés, jusqu'aux salles de données virtuelles pour les documents confidentiels.

Dans le cloud, tout ceci est actif par défaut, et sur un serveur, une seule commande suffit à les installer.

Dans les éditeurs, c'est le PDF qui récupère les nouveautés les plus pratiques puisqu'il sait maintenant effacer les métadonnées et autres informations cachées d'un fichier avant de l'envoyer, mais aussi régler la bordure, le fond et l'opacité de vos annotations, et quand vous modifiez le texte d'un PDF, les tableaux sont reconnus tout seuls, ce qui évite de reconstruire les lignes et les colonnes à la mano.

Les signatures, quant à elles, s'enregistrent une seule fois et peuvent ensuite être réutilisées dans d'autres formulaires. C'est pratique pour signer des papiers vite fait sans avoir à imprimer > signer > numériser. Moi, j'utilise que ça tout le temps.

Avant de partager un PDF, cette fenêtre efface ses métadonnées et ses informations cachées

Dans le traitement de texte, quand c'est en mode collaboratif, vous pouvez ainsi suivre le curseur d'un collègue en temps réel pendant la coédition. L'option "Conserver avec le suivant" évite également qu'un titre se retrouve tout seul en bas de page, séparé de son contenu, et l'écriture de droite à gauche est plus fiable. Le tableur, lui, va plus vite, notamment sur des fonctions comme SUMIF ou COUNTIFS qui ont été optimisées. Il vous indique également où placer chacune des constantes dont vous avez besoin pendant que vous tapez une formule. Et surtout, une jolie petite bordure animée vous montre ce que vous venez de copier.

Bref, c'est super pratique au quotidien !

Pendant la saisie d'une formule, une bulle indique la place de l'année, du mois et du jour dans la fonction DATE

Pour les présentations, il y a de nouveaux modes d'affichage (plan, lecture...), des options d'impression bien plus complètes et surtout l'export de vos diapos en GIF ou en vidéo, ce qui est bien pratique pour les partager sur vos réseaux sociaux.

Et dans toute la suite, vous pouvez aussi ouvrir les fichiers .ofd, enregistrer un tableur au bon vieux format .xls et convertir une image SVG en forme modifiable.

Et c'est sans compter sur la communauté d'ONLYOFFICE qui apporte aussi de nouveaux plugins, comme Antidote pour l'orthographe et la grammaire, Curly ou Salesforce, le tout rangé dans un gestionnaire de plugins refait au propre pour cette nouvelle release.

Les deux fenêtres d'export d'une présentation, en animation GIF ou en vidéo

Côté sécurité, ONLYOFFICE annonce environ 35 vulnérabilités corrigées, et promet un billet détaillé sur le sujet prochainement.

L'application de bureau Desktop Editors gagne une page d'accueil repensée, des sections Modèles et Clouds revues, une intégration avec Odoo et des retouches visuelles sous Linux pour que ce soit un peu plus joli pour les amateurs de libre.

Quant aux applis gratuites pour iOS et Android, elles ont le droit à un assistant IA qui accepte de nouveaux fournisseurs comme Grok et DeepSeek, et également droit au remplissage automatique des formulaires par IA et à la saisie vocale (C'est le genre de fonction dont je peux vraiment plus me passer, moi, la saisie vocale).

Voilà, si vous voulez voir tout ça vous-même, c'est super simple ! Il vous suffit de passer par le cloud d'ONLYOFFICE, d'installer les applications de bureau ou alors si vous êtes un petit peu chaud de déployer la version serveur chez vous pour tout garder au chaud à la maison.

Découvrir ONLYOFFICE 10.0

🔲 ☆

Slot - Quand l'Anbernic RG SP se prend pour une vraie GBA SP

Slot est une interface incroyable pour la console portable Anbernic RG SP (lien affilié) qui ne lit que la Game Boy, la Game Boy Color et la Game Boy Advance. Mais il retrouve les gestes d'une GBA SP sur laquelle vos jeux deviennent des cartouches sur une étagère, et qui font le même bruit que celle qu'on enfonce IRL dans sa GBA d'enfance.

Voici ce que ça donne :

L'interface de slot : les cartouches GBA défilent sur l'étagère, puis une cartouche Pokémon s'enfonce dans la fente et le jeu démarre

Si vous appuyez sur la touche Start, la cartouche se retournera pour afficher son circuit imprimé. Et à partir de là, vous pourrez choisir l'émulateur que vous voulez entre mGBA et gpSP.

Un appui sur la touche A relancera la dernière sauvegarde et si vous faites un appui long, vous repartirez de zéro. Maintenant, si vous voulez éjecter la cartouche, il faudra laisser le bouton Menu enfoncé. Et ça permettra de créer une nouvelle sauvegarde instantanément pour ne pas perdre votre progression en changeant de jeu.

Le clapet suit le même principe... le refermer écrit une sauvegarde et éteint l'écran, et au bout de trois minutes slot éteint la console, qui reprendra au même endroit au démarrage suivant. Même le câble link passe par le Wi-Fi entre deux RG SP, de quoi échanger des Pokémon sur Émeraude, Rouge Feu et Vert Feuille.

Après, ce soft slot est bridé exprès puisqu'il dit "non" aux autres systèmes d'émulation. En fait, l'auteur voulait vraiment et uniquement une expérience similaire à ce qu'il avait avec sa GBA SP d'enfance. Donc il n'a pas non plus intégré les RetroAchievements ni les Cheats et encore moins tout ce qui était Bluetooth (c'est la prise jack ou rien).

Donc si vous voulez d'autres consoles, SpruceOS , dont je vous ai parlé en septembre, en gèrera bien plus.

Côté machines, slot tourne sur la RG SP, les RG34XX, RG34XXSP (sans le stick pour l'instant), RG35XXSP et 35XX Plus, et depuis la 1.6.0 sur la RG28XX. Le code est bien sûr sous licence GPL-3.0, et l'auteur précise que le frontend a été écrit par Claude Opus, puis relu par lui. C'est maintenant un gage de qualité car, eh, qui veut encore développer des outils à l'ancienne ? (lol, oui j'essaye de vous trigger !!)

Pour l'installer, il faut flasher BaseOS , l'image système de Prashant Vaibhav, sur une carte SD, puis démarrer la console une fois pour qu'elle étende le stockage. Ensuite, vous copiez le contenu de l'archive de slot à la racine de la carte et vous rangez vos ROMs dans leur dossier des plateformes sous Games/. Elles doivent être décompressées puisque slot ne lit ni les .zip ni les .7z.

Et pour faire une mise à jour, suffit de remplacer le dossier System/, sans toucher aux jeux ni aux sauvegardes. Le reste, y compris la variante à deux cartes SD où slot et vos jeux sont sur la seconde, est indiqué dans le guide du projet .

🔲 ⭐

gbos-vm - Pour vous amuser dans Googlebook OS depuis votre Mac

Vous avez envie de voir à quoi ressemble Googlebook OS , mais pas du tout envie de dégainer +1000 balles pour un ordi bridé ? Ça tombe bien, un développeur a codé gbos-vm , un outil open source sous licence MIT qui lance sur un Mac Apple Silicon l'image de recovery de Google (conçu à l'origine pour le Dell Googlebook), dans une machine virtuelle boostée par le GPU.

Ce n'est donc pas un Android générique habillé en Googlebook mais un script qui télécharge l'image officielle (la build 16471258, ARM64, Android 17), en vérifiant l'empreinte, puis la fait démarrer sous QEMU avec Vulkan traduit vers Metal. Et rien de chez Google n'est redistribué dans le dépôt (pas de Playstore de base donc...).

Côté Mac, il vous faut donc un Mac avec archi Silicon, Homebrew, les outils en ligne de commande de Xcode, un JDK et le SDK Android (plateforme API 34 minimum) avec son NDK. Et comptez 16 Go de RAM en pratique car la VM en squatte 4 mais les compilations successives en auront besoin d'un peu plus. Et le script installera de lui-même tout ce qui vous manquera côté Homebrew, sans jamais vous demander un accès via sudo. Comptez environ 9 Go pour le download de tout ça et minimum 60 Go de libre pour la VM.

git clone https://github.com/skylartaylor/gbos-vm.git
cd gbos-vm
./install.sh

Ensuite, vous ouvrez l'application construite (dispo dans work/host/Googlebook VM.app), dont la mission est de lancer la VM et de l'éteindre proprement quand vous la quittez.

Le premier boot prendra environ 45 secondes sur un MacBook M5 et si un sélecteur d'utilisateur s'affiche, cliquez juste sur "User" et y'a pas de mot de passe. Notez que la souris est capturée par défaut, et que le raccourci ⌃⌥ la libèrera.

Voilà, c'est pas encore parfait car le bluetooth peut crasher, on est limité à 60 images par seconde max et que les échanges entre la VM et l'hôte (le mac) sont un peu instables mais j'imagine que tout ceci se bonifiera avec le temps...

🔲 ☆

Omarchy, non merci

Ces derniers temps, il y a beaucoup de hype sur la distribution Linux Omarchy.

C'est sûr qu'elle présente de nombreux avantages comme une installation en moins de 2 minutes sur la plupart des machines, un bureau en mosaïque pilotable au clavier et des thèmes qui changent réellement l'habillage de tout le système mais elle est aussi vivement critiquée par les puristes du libre parce que, pour certains, elle ne serait qu'une Arch Linux avec les dotfiles de son créateur DHH (David Heinemeier Hansson). Pour Matthew Garrett , fervent défenseur du libre, elle est même, je cite "fondamentalement incompatible avec les objectifs du logiciel libre".

Bon, moi vous me connaissez, ces guerres de clochers techniques, ça ne me passionne pas... Et pourtant, aujourd'hui, Omarchy vient clairement de changer de visage. En effet, suite à mon article d'hier sur un projet en lien justement avec Omarchy, un lecteur de Korben.info m'a averti que DHH, le créateur d'Omarchy, diffusait actuellement de "drôles" d'idées sur son blog , où il publie depuis plus d'un an, des billets notamment sur l'immigration en Europe.

Je vous cite quelques extraits que j'ai traduits en dessous :

"Unwilling to resign the rest of the country to the kind of demographic replacement that befell London over the last two decades."

"Refusant de se résigner à voir le reste du pays subir le genre de remplacement démographique qui a frappé Londres ces vingt dernières années."

"As I remember London", septembre 2025

"Like an immigration policy designed to rival America's cherry-picking of the world's best, rather than mass immigration from low-average-IQ regions of net-negative contributors to the economy (and society)."

"Par exemple une politique d'immigration conçue pour rivaliser avec la manière dont l'Amérique va chercher les meilleurs du monde, plutôt qu'une immigration de masse venue de régions au QI moyen bas, faite de contributeurs nets négatifs pour l'économie (et la société)."

"Europe is weak and delusional (but not doomed)", 9 décembre 2025

"You can't save the continent's declining birth rate, growing retiree burden, or even economy as a whole by importing millions of people from a culturally incompatible third world."

"On ne sauvera ni la natalité en baisse du continent, ni le poids croissant des retraités, ni même son économie, en important des millions de personnes d'un tiers-monde culturellement incompatible."

"Three sacred cows that must die so Europe can live", 16 juillet 2026

"Because the sacred cow here is not just that mass migration must stop going forward. It's also that millions who are already in Europe must go."

"Parce que la vache sacrée ici n'est pas seulement qu'il faut arrêter l'immigration de masse pour l'avenir. C'est aussi que des millions de personnes qui sont déjà en Europe doivent partir."

"Three sacred cows that must die so Europe can live", 16 juillet 2026

"When wolves get out of control, you shoot them. When gypsies take over public spaces, you deport them."

"Quand les loups deviennent incontrôlables, on les abat. Quand des gypsies s'emparent de l'espace public, on les expulse."

"Wolves, sheep, and gypsies", 21 juillet 2026 ("gypsies" est son mot, je ne l'ai pas traduit)

Alors oui, je sais, les idées de merde ont le vent en poupe en ce moment, et je vais encore tendre des strings avec cet article mais bon, comme toujours je m'en tape parce que c'est impossible pour moi d'ignorer ça.

Je sais que certains vont encore venir me dire que je n'ai pas à faire de "politique", mais sachez que de mon point de vue, ça n'en est pas. La xénophobie et les idées anti-démocratiques n'ont pas leur place sur l'échiquier politique. C'est un cancer qui n'a d'autre but que d'anéantir la démocratie, et je trouve aberrant que l'organisme vivant "démocratie" accueille cette maladie mortelle à bras ouverts. Mais bref...

Ce genre d'idées que diffuse DHH et d'autres, si on peut appeler ça des idées, en plus d'être faciles à penser, totalement pré-machées, ce sont des idées mortifères à la fois pour les humains et pour la démocratie. Ce sont des idées dont nos parents et grands-parents ont été victimes durant la seconde guerre mondiale et l'occupation, et dont beaucoup de monde sont encore victimes tous les jours ( dernier exemple en date qui m'a choqué ).

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Bref, avec Omarchy, ce n'est pas possible pour moi de dissocier l'homme de l'artiste ou devrais-je dire, dissocier le développeur de ses idées racistes. La xénophobie est un "choix" quasi primitif en terme de logique, j'en conviens. Ça ne demande pas trop d'effort et ça permet de rendre responsable "les autres" de tous ses problèmes, ce qui évite aux gens d'endosser leurs responsabilités, de se prendre en main, ou d'être solidaires comme le feraient des adultes. C'est clairement un désir de confort qui s'adosse à la haine, mais ça n'a jamais été une solution.

Et Omarchy étant très fortement incarnée par DHH, qui adore mettre son nom partout sur le site web de cette distrib, c'est difficile d'ignorer la situation. Bien sûr, je sais qu'il y a, à ses côtés de nombreux contributeurs qui ne connaissent pas et ne partagent pas ses idées et c'est pareil avec les utilisateurs de cette distrib.

Mais maintenant qu'on est tous au courant, je pense qu'il est temps d'être cohérent avec nos valeurs qu'elles soient libristes, humanistes ou démocratiques pour ne pas faire par exemple comme 1Password et 37signals qui s'engagent à financer ce projet à hauteur de 100 000 dollars par an chacun, tout en affirmant, comme l'a fait le PDG de 1Password, que, hey, l'entreprise n'approuve pas les opinions de DHH, donc que c'est bon, y'a totem d'immunité.

Bah non, moi je trouve ça trop facile.

Donc voilà, vous faites ce que vous voulez mais maintenant que je sais quelles sont les idées de celui sur qui repose Omarchy, ne comptez plus sur moi pour utiliser et promouvoir cette distrib.

🔲 ☆

Du dev iPhone sans Mac sur Omarchy

Mise à jour du 8 octobre 2026 : depuis la publication de cet article, j'ai découvert les idées que diffuse DHH, le créateur d'Omarchy. Je ne recommande plus cette distribution, et je vous explique pourquoi dans Omarchy, non merci .

Omarchy-apple-dev , c'est un projet qui vous permet de compiler une app codée en SwiftUI, l'installer sur votre iPhone via le cable USB et l'envoyer à TestFlight d'Apple, tout ça depuis une machine Linux sous Omarchy... Oui oui, sans Mac !

Le gros du boulot est assuré par xtool , qui sait déjà compiler, signer et installer une app iOS sous Linux, mais ce dépôt omarchy-apple-dev y ajoute un script ship.sh, qui permet de créer le .ipa, d'y renseigner les clés de build que le traitement App Store lit, puis d'envoyer tout ça à Apple comme un grand.

Bref, en langage clair, ça veut dire que vous pouvez être développeur iOS depuis votre PC Linux. Cool hein ?

Pour l'installer, c'est juste 3 lignes avec install du SDK d'Apple.

git clone https://github.com/joshuaswarren/omarchy-apple-dev
cd omarchy-apple-dev
./install-toolchain.sh

Les morceaux du SDK iOS n'existant que dans la distribution Xcode d'Apple, il faut donc télécharger le Xcode.xip sur developer.apple.com avec un Apple ID gratuit, depuis n'importe quel OS. Vous relancez ensuite le script avec XCODE_XIP=/chemin/Xcode.xip, puis device-run.sh installera l'app sur l'iPhone branché. Un compte gratuit suffit pour ça, mais Apple le limite à 3 apps par appareil avec des profils qui expirent au bout de 7 jours. Pour TestFlight, il faudra par contre un compte développeur payant et une clé d'API App Store Connect.

Après, les CGU d'Apple pour Xcode et ses SDK disent bien que ces logiciels ne sont autorisés uniquement sur un produit de marque Apple tournant sous macOS, et que tout autre usage est une violation du contrat. Sa clause 2.5 interdit aussi d'utiliser les SDK séparément ou de les faire tourner sur du matériel qui n'est pas Apple. Or le SDK que le script installe vient forcément d'un Xcode d'Apple. Voilà, au moins vous savez...

Bref, pour bricoler sur votre iPhone avec un compte gratuit, ça peut le faire... Après, pour l'App Store, sachez qu'Apple exige en plus depuis avril dernier, que vos apps soient compilées avec Xcode 26 ou plus récente alors qu'ici, ce bon vieux script contourne ça... Donc à voir si vous voulez tenter votre chance.

Au pire, pour la phase finale (la compilation de la release de votre app), vous sortez un Mac rien que pour ça et le reste du temps, vous codez et compilez vos tests à 100% dans Omarchy. A vous de voir :)

🔲 ☆

The Legend of Zelda: Majora's Mask enfin en version européenne sur PC et Android

Vous le savez, The Legend of Zelda: Majora's Mask existe en version européenne, avec une ROM PAL 1.1 qui embarque 4 langues (anglais, français, allemand et espagnol), mais 2Ship2Harkinian , le portage PC du jeu dont je vous ai déjà parlé, ne reconnaît que les 2 versions américaines.

C'est pour cela qu'un fork non officiel a décidé de lever cette limite en permettant une lecture de la ROM version PAL 1.1 directement depuis Windows, Linux et Android !

Bien sûr, le fork garde le support des ROM américaines, et comme toujours pour ne pas tomber dans le piratage, il faudra au premier lancement du jeu, désigner l'emplacement de votre ROM à vous (que vous devrez avoir normalement rippé vous-même depuis votre propre version pour rester dans les clous plutôt que dans choper une sur un site random ^^). Ensuite, le jeu génèrera localement son fichier de données (mm.o2r), et les lancements suivants démarreront directement dans le jeu.

Le menu Options sur Android, avec le français sélectionné parmi les quatre langues de la ROM PAL 1.1 (capture fournie par l'auteur du fork)

Sous Windows, il faut donc décompresser le ZIP et lancer 2ship.exe, en gardant 2ship.o2r à côté. Sous Linux, c'est une archive et un exécutable 2s2h.elf, avec le même fichier à ses côtés. Sur Android, il faut l'APK (ARM64 uniquement, Android 7 et OpenGL ES 3.0 minimum), et la version mobile ajoute des commandes tactiles qu'on peut masquer, un menu redimensionnable et un dossier de données déplaçable sur carte SD.

Pas de build macOS, en revanche, alors que le projet d'origine en propose un et ça, c'est un méga snif pour moi.

Alex, l'auteur de ce fork a aussi ouvert une demande de fusion chez 2Ship pour intégrer tout ça au projet d'origine, j'espère que ça passera.

Et après, peut-être qu'il pourra s'attaquer à Zelda 64 Recompiled , l'autre portage de Majora's Mask dont je vous ai parlé, car lui aussi n'accepte que la ROM américaine..

À récupérer sur la page des releases du fork .

🔲 ☆

OpenMouse - Réglez votre souris gaming depuis le navigateur

Si vous avez la chance de rentrer de manif avec vos 2 mains, parce que hé, "c'est la démocratie", voici un outil qui va vous intéresser ! Ça s'appelle OpenMouse et c'est un configurateur de souris gaming qui fonctionne direct dans le navigateur. Vous branchez votre souris, vous ouvrez le site dans Chrome ou Edge, et vous réglez le DPI, le polling rate, et les boutons et le RGB (selon ce que votre modèle sait faire).

L'outil n'envoie aucune donnée à l'extérieur et en plus, c'est gratuit et sous licence AGPL. Maintenant, est-ce que ça va fonctionner avec votre souris ? C'est la grande question ! La liste du projet suit actuellement 746 appareils, dont 232 sont taggés comme "Compatible", c'est-à-dire confirmés fonctionnels avec un driver enregistré. Les autres sont des modèles demandés par la communauté, ou qui attendent un test matériel ou un driver.

Chez Logitech par exemple, la G502, la MX Master 3S et la G Pro X Superlight en font partie. Chez Razer, la DeathAdder V3 et la Viper V3 Pro aussi, mais la Basilisk V3 attend encore un test sur du vrai matériel.

Après, "Compatible" ne veut pas dire que tout se règle direct. La Corsair Nightsword RGB est marqué comme tel et pourtant, elle est en lecture seule (il faut fermer l'outil iCUE avant), et plusieurs autres modèles de la marque affichent "Driver nécessaire".

Et si vous avez une Razer sous Windows ?

Alors là, il vous faudra un utilitaire en plus car depuis Chrome 153, une page web ne peut plus toucher à la souris via l'interface que Razer utilise. En effet, Chrome a corrigé un bug Windows qui, d'après le billet d'OpenMouse daté du 12 septembre dernier, laissait cet accès ouvert depuis des années. Les Razer ont donc cessé de s'y connecter, ce qui fait que pour le projet, la seule solution c'est Bridge , un utilitaire optionnel qui s'installe sur l'ordi et qui permet de faire le lien entre la souris et l'app web.

Bridge est cool parce qu'elle permet aussi d'utiliser OpenMouse sous Firefox (Safari n'est pas encore supporté), ainsi que d'appliquer un profil de réglages au lancement d'un jeu, ou encore de vous prévenir quand la batterie de votre souris sans fil passe sous 20 %.

Par contre, c'est encore une bêta donc il n'y a aucune garantie ! À tester !

🔲 ☆

OpenCat – Le framework open source des animaux de compagnie robotiques

Aujourd’hui, j’aimerai vous parler OpenCat, un framework open source qui va vous aider à créer vos propres robots animaux de compagnie, c’est à dire des quadrupèdes hyper réalistes et Ô surprise parfaitement abordables. Pour cela, OpenCat permet de piloter des servomoteurs haute performance utilisés comme articulations, une structure de corps optimisée et des contrôleurs low-cost comme Arduino, ESP32 ou Raspberry Pi.

Vous pouvez également ajouter plein de modules trop cools comme une caméra intelligente, des capteurs IoT ou encore une commande vocale. Avec le code de contrôle open source hyper efficace, vos robots vont littéralement prendre vie !

OpenCat, c’est pas non plus juste un délire de geek barbu puisque ça a déjà été déployé sur des robots commerciaux comme le chat Nybble et le chien Bittle de Petoi. Ces petites merveilles de technologie peuvent courir, marcher et même s’auto-équilibrer comme de vrais animaux.

Les créateurs d’OpenCat partagent tout ça en open source pour une bonne raison : Ils veulent favoriser la collaboration dans le développement de la robotique, de l’IoT et de l’IA sur des robots quadrupèdes abordables. Ils veulent également diffuser des ressources éducatives sur la robotique au plus grand nombre et inspirer les étudiants, les ados et même les enfants. C’est beau quand même !

Bref, si vous aussi vous rêvez de construire vos propres robots animaux de compagnie, foncez sur OpenCat ! C’est le moment de mettre les mains dans le cambouis, d’apprendre en s’amusant et de participer à cette aventure.

🔲 ☆

RaspRover – Le kit robot 4×4 pour Raspberry Pi 4 et 5

Vous rêvez de vous initier au monde de la robotique et de l’intelligence artificielle ?

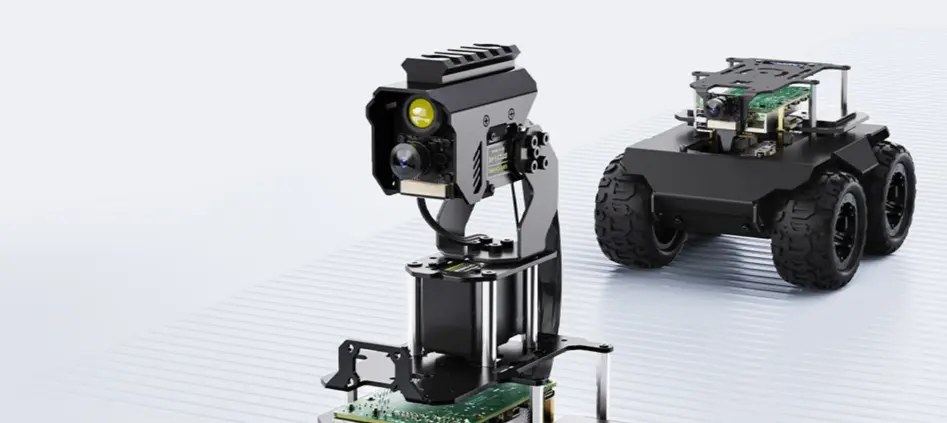
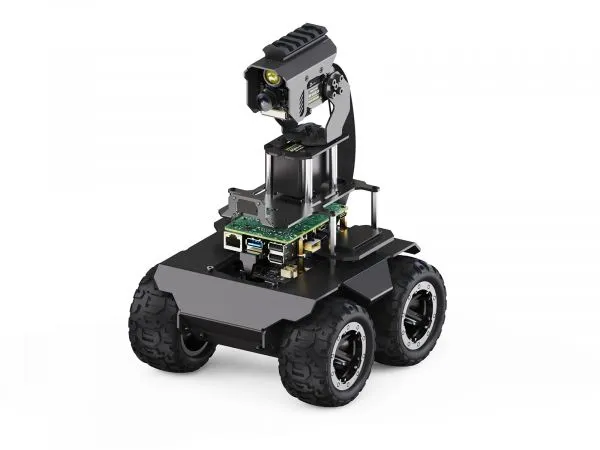
Ca tombe bien puisque ce kit RaspRover va vous permettre de réaliser ce doux rêve ! Ce petit robot 4×4 hyper versatile est le compagnon idéal pour partir à l’aventure car il embarque un Raspberry Pi dernière génération (modèles 4 ou 5) ce qui va vous permettre de laisser libre cours à votre créativité en le programmant vous-même.

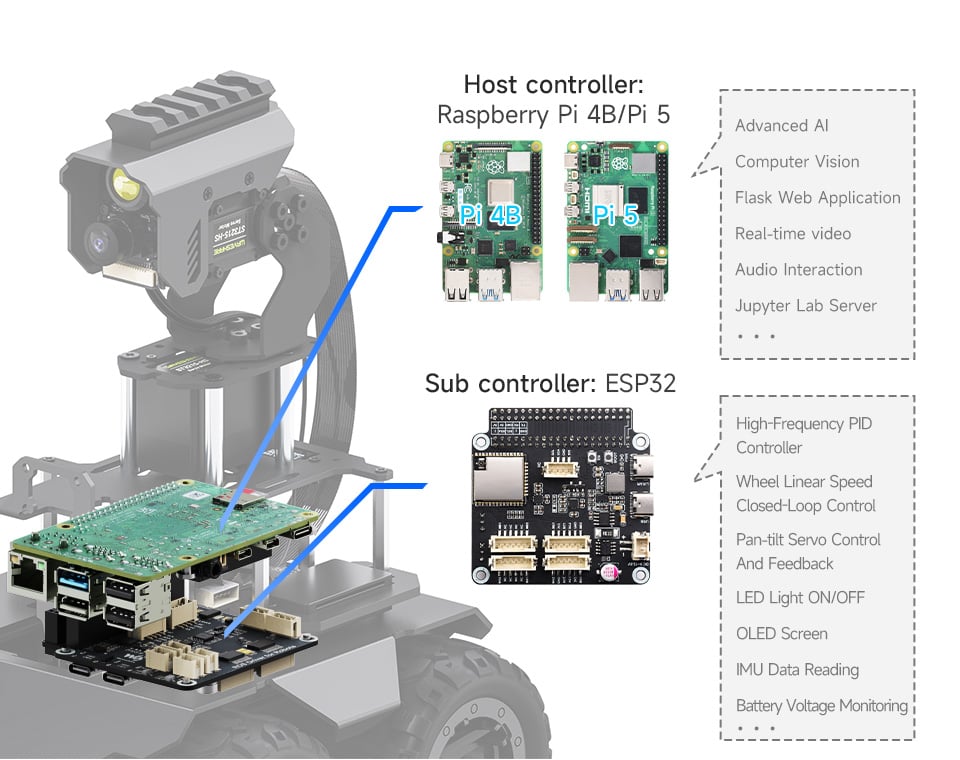
Et pas besoin d’être un crack en informatique pour dompter ce robot puisque tout est pensé pour faciliter sa prise en main. En effet, sous le capot, vous trouverez un double contrôleur avec d’un côté le Raspberry Pi qui gère les fonctions IA de haut niveau pendant que de l’autre, un microcontrôleur se charge des opérations basiques à haute fréquence. Comme ça, chaque action que vous lui demandez est précise et fluide.

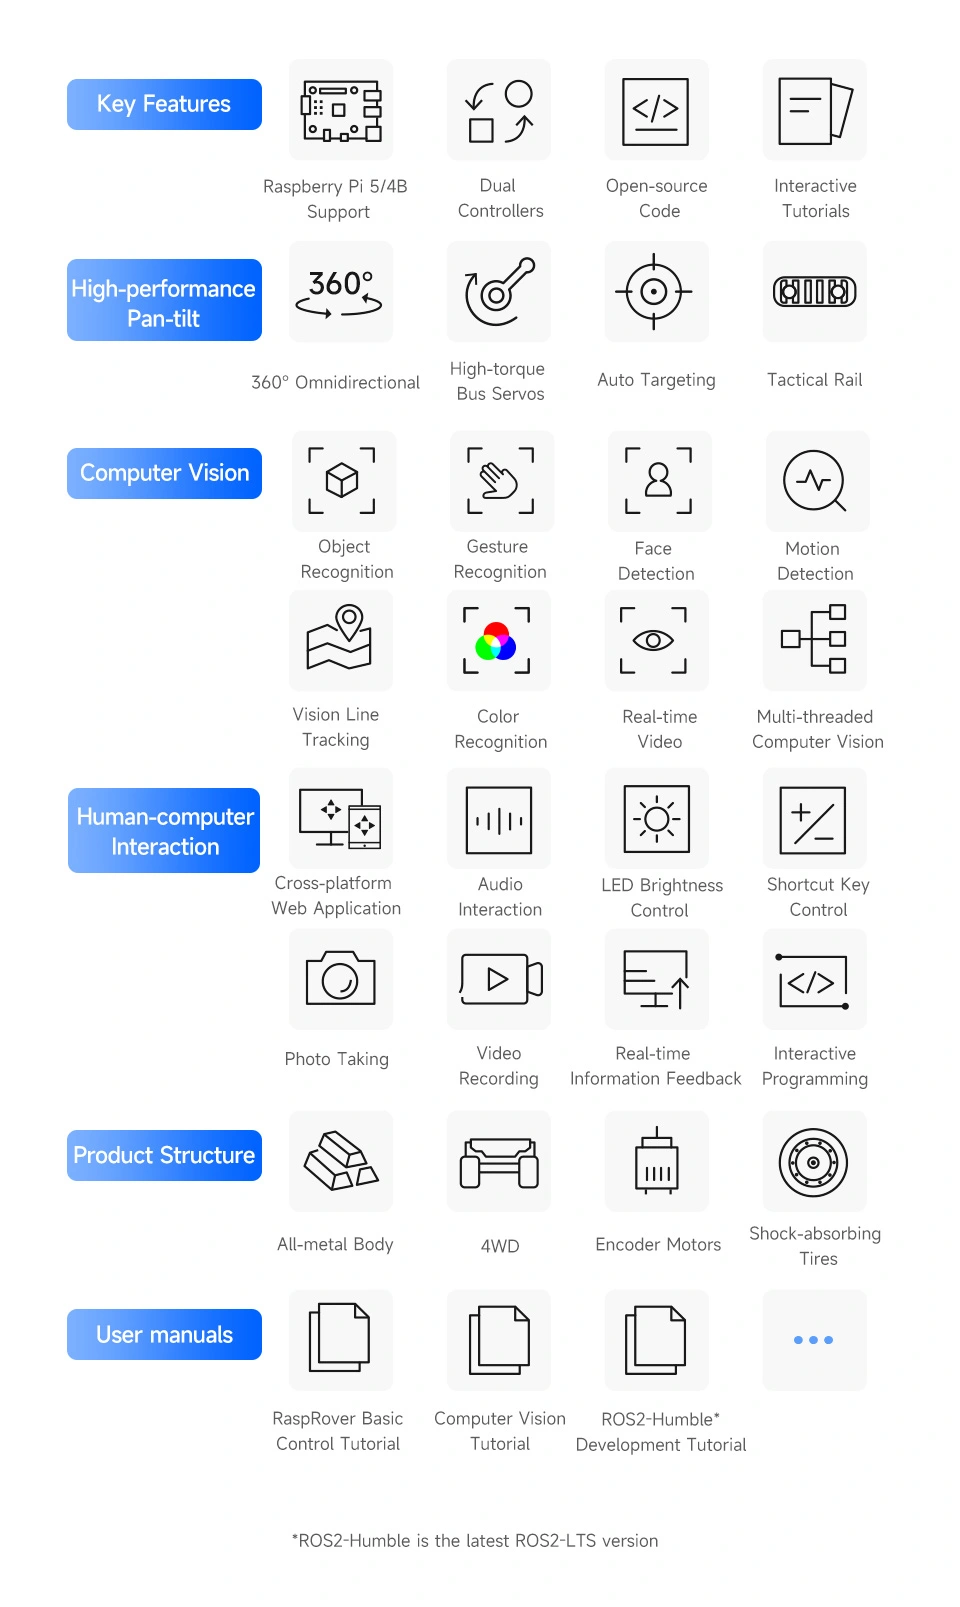
Côté perception, le RaspRover a du flair grâce à sa caméra mobile grand angle qui lui offre une vision périphérique à 160°. Couplée à l’IA de reconnaissance d’images de OpenCV, cette caméra détecte et piste les visages ou les objets. Bref, de quoi lui permettre d’interagir avec son environnement sans souci.

Et ce n’est pas tout puisqu’il dispose d’une panoplie de capteurs (IMU 9 axes, télémètre laser…) qui décuplent ses talents : cartographie, évitement d’obstacles, localisation précise… et son architecture modulaire et ses nombreuses interfaces (GPIO, USB, I2C, UART…) lui permettent d’accueillir une foule d’accessoires : bras robotique, capteurs environnementaux, module 4G/5G… De quoi l’adapter à une infinité de scénarios comme de l’agriculture de précision, l’inspection de sites industriels, de la télé-surveillance, pour l’éducation, la recherche…

Et bien sûr, il carbure à l’open source ce qui veut dire que vous pouvez personnaliser son code et ajouter vos propres fonctionnalités. De plus, grâce au protocole ESP-NOW, plusieurs RaspRover peuvent même communiquer et collaborer entre eux ! Imaginez l’escouade de robots que vous allez pouvoir programmer avec ce truc.

Si ça vous dit, y’a un super Wiki qui vous explique comment monter et programmer tout ça.

🔲 ☆

Personal vs. Personalized AI

There is a war going on. Humanity and nature are on one side and Big Tech is on the other. The two sides are not opposed. They are orthogonal. The human side is horizontal and the Big Tech side is vertical.*

The human side is personal, social, self-governed, heterarchical, open, and grounded in the physical world. Its model is nature, and the cooperative contexts in which competition, creation, and destruction happen in the natural world.

The Big Tech side is corporate, industrial, hierarchical, competitive, mechanistic, extractive, and closed, even though it produces many positive-sum products and services that are good for people and good for nature. It is also, being competitive and rewarding toward winner-take-most outcomes, dominated by giants.

This war has been fought over many other things in the past, especially in tech. But AI is the big one right now—and perhaps the biggest one of all time.

Over the long run, both sides will win, because we need the best of what both bring to the world’s big round table. In the past, this has happened in countless markets, countries, polities, societies, and other contexts. In tech it happened with the conflict between PCs and mainframes, between the open and public Internet and closed private networks, and between open operating systems and closed ones. None of those conflicts have final outcomes, but they have arrived at stable and cooperative states. They arrived at those states because everyone recognized that people can do more with their own tools than those big entities can do on theirs, or by using people as extracted resources.

This conflict is perhaps best represented by the ironies that have been at work within OpenAI and Sam Altman, its prior and current CEO. We can also see it with sparkling clarity in something amazing that Sam said near the close of his keynote at the first OpenAI Developer Conference, in November of last year:

Lets unpack that.

Individual empowerment means exactly what it says. Agency is the ability to take action or to choose what action to take (Cambridge Dictionary). Scale means growth toward ubiquity.

You have individual empowerment and agency when you ride your bike, drive your car, mow your lawn, or button your shirt. You also have it when you work on your laptop, phone, and other smart rectangles. Scale means your power and agency will grow to the max while the same will happen for nearly everyone else. Scale for you alone won’t cut it. When most of us have it, that’s scale.

Technologies extend us. They enlarge our capacities in the world. Intelligence is one of those capacities. So is memory. Your rectangles help a lot with both. That’s why those have already scaled to ubiquity, or close enough.

AI will do the same, but only if it’s personal. Not if it’s  just “personalized.”

As Jamie Smith made clear here a year ago, “your personal AI isn’t really personal.”

ChatGPT4 doesn’t know that yet. I can tell because I just asked:

Me:
What is “personal AI”?

ChatGPT4:
“Personal AI” refers to artificial intelligence systems that are designed to serve individual users through personalized interactions and services. These AI systems learn from the specific preferences, behaviors, and needs of their users to offer more tailored assistance, recommendations, or information. The goal of personal AI is to enhance user experience by adapting to unique personal profiles.

There are various applications of personal AI, including:

  1. Virtual Assistants: Like Siri, Google Assistant, and others, these AIs help with daily tasks such as scheduling, reminders, searching information, and controlling smart home devices, all customized to the user’s habits and preferences.
  2. Recommendation Systems: Used in streaming services like Netflix or shopping platforms like Amazon, these AI systems analyze your past behavior to recommend movies, shows, or products you might like.
  3. Healthcare: Personal AI can track individual health metrics and provide personalized advice, monitor conditions, or even alert medical professionals if needed.
  4. Learning and Development: In education, personal AI can adapt learning materials to the pace and learning style of the student, offering a customized educational experience.
  5. Gaming: AI in gaming can adapt to provide a challenge tailored to the player’s skill level or alter the game narrative based on choices made by the player.

The development of personal AI focuses on enhancing user engagement by creating more intuitive and responsive interactions that feel uniquely suited to each individual.

For a second opinion, I asked Google’s Gemini the same question.

Me:
What is “personal AI”?

Gemini:
Personal AI refers to artificial intelligence designed to assist and interact with a specific individual. It’s essentially your own AI companion that learns about you and tailors its services to your needs. Here are some key aspects of personal AI:

  1. Personalization: Unlike general-purpose AI assistants, personal AI focuses on you. It learns from your interactions, preferences, and habits to become more helpful over time.
  2. Focus on Memory and Knowledge: Some personal AI systems aim to become an extension of your mind. They can store your memories, knowledge, and experiences, making them readily accessible and even usable to help with tasks like writing or communication.
  3. Varied Applications: Personal AI can have a wide range of applications. Imagine an AI that helps you:
  4. Organize your life: Manage schedules, appointments, and reminders.
  5. Boost productivity: Assist with tasks, research, and communication.
  6. Enhance creativity: Help you brainstorm ideas or generate creative content.
  7. Improve learning: Personalize learning experiences and provide targeted information.

Privacy Concerns: Storing personal data on an AI raises concerns about privacy and security.

Overall, personal AI holds promise for a future where technology seamlessly integrates with our lives, offering personalized assistance and support.

To both companies, personal AI is a personalized service—from them. It’s not something you own and control. It’s not about individual empowerment and agency. It doesn’t extend you. It’s hired prosthesis: an extension of them rather than of you.

Let’s name the category: AIaaS—AI as a Service.

But hats off. OpenAI and Gemini do amazing jobs. So do lots of other AI services by wannabe giants. I use AI every day to improve what I write, to generate and fix images, to answer questions that old-fashioned search engines can’t answer or suck at. I even pay extra for some of it (such as ChatGPT4 and Adobe’s Creative Suite). And it seems they all get better, all the time, at everything. Won’t personalization be good enough, eventually?

No. Because they aren’t you. They also aren’t yours, so they can’t extend you. They can seem to. But they don’t. They also don’t have access to most of your private life. Nor should they.

But your private life could use some AI help. For example—

  • Schedules, including on your calendars, past and future
  • Health data, including all your medical reports, prescriptions, appointments, insurance information, past and present providers, plus what your watch, phone, and other devices record about you
  • Financial records, including bills, receipts, taxes, and anything called an account that involves money
  • Travel, including all the movements your phone (and phone company), watch, and car record about where you go and where you’ve been
  • Work—past and present, including whatever HR systems know or knew about you
  • Contacts—all the people, businesses, and other entities you know
  • Business relationships, with brokers, retailers, service providers, whatever
  • Subscriptions, including all those “just $1 for the first four weeks” offers you’ve accepted, plus other forms of screwage that are stock-in-trade for companies selling subscription systems to businesses.
  • Property, including all the stuff on your shelves, floors, closets, garages, and storage spaces—plus your stocks and real estate.

It’s not easy to visualize what a personal AI might do for those, but let’s try. Here’s how Microsoft’s Copilot (or whatever it’s called this week) did it for me before I got rid of all its misspellings and added my own hunks of text:

All that stuff is data. But most of it is scattered between apps and clouds belonging to Apple, Google, Microsoft, Amazon, Meta, phone companies, cable companies, car makers, health care systems, insurance companies, banks, credit card companies, retailers, and other systems that are not yours. And most of them also think that data is theirs and not yours.

To collect and manage all that stuff, you need tools that don’t yet exist: tools that are yours and not theirs. We could hardly begin to imagine those tools before AI came along. Now we can.

For example, you should be able to take a picture of the books on your shelves and have a complete record of what those books are and where you got them. You’ll know where you got them because you have a complete history of what you bought, where and from whom. You should be able to point your camera in your closets, at the rugs on your floors, at your furniture, at the VIN number of your car that’s visible under your windshield, at your appliances and plumbing fixtures, and have your AI tell you what those are, or at least make far more educated guesses than you can make on your own.

Yes, your AI should be able to tap into external databases and AI systems for help, but without divulging identity information or other private data. Those services should be dependent variables, not independent ones. For full individual empowerment and agency, you need to be independent. So does everyone else with personal AI.

Now imagine having a scanner that you can feed every bill, every receipt, every subscription renewal notice, and have AI software that tells you what’s what with each of them, and sorts records into the places they belong.

Ever notice that the Amazon line items on your credit card bill not only aren’t itemized, but don’t match Amazon’s online record of what you ordered? Your personal AI can sort that out. It can help say which are business and personal expenses, which are suspicious in some way, what doesn’t add up, and much more.

Your personal AI should be able to answer questions like, How many times have I had lunch at this place? Who was I with? When was it we drove to see so-and-so in Wisconsin? What route did we take? What was that one car we rented that we actually liked?

Way back in 1995, when our family first got on the Internet over dial-up, using the first graphical browsers on our PC, and e-commerce began to take off with Amazon, eBay, and other online retailers, my wife asked an essential question: Why can’t I have my own shopping cart that I take from site to site?

Twenty-nine years later, we still don’t have the answer, because every retailer wants you to use its own. And we’re stuck in that system. It’s the same system that has us separately consenting to what sites ironically call “your privacy choices.” And aren’t.

There are countless nice things we can’t have in the digital world today because we aren’t people there. We are accounts. And we are reduced to accounts by every entity that requires a login and password.

This system is a legacy of client-server, a euphemism for slave-master. We might also call it calf-cow, because that’s how we relate to businesses with which we have accounts. And that model is leveraged on the Web like this:

We go to sites for the milk of content and free cookies, whether we want them or not. We are also just “users.”

In the client-server world, servers get scale. Clients have no more scale than what each account—each cow—separately allows. Sure, users get lots of benefits, but scale across many cows is not one of them. And no, “login with Google” and “login with Facebook” are just passes that let calves of ruling cows wander into vassal pastures.

For individual empowerment and scale to happen, we need to be self-sovereign and independent. Personal AI can give that to us. It can do that by solving problems such as the ones listed above, and by working as agents that represent us as human beings—rather than mere users—when we engage with Big Tech’s cows.

This will be a fight at first, because the cows think they run all of nature and not just their own farms. And $trillions are being invested in the same old cattle industry, with AI painted all over the new barns. Comparatively speaking, close to nothing is going toward giving independent and self-sovereign individuals the kind of power and scale Sam Altman says he wants to give us but can’t because he’s on the big cow side of this thing.

So where do we start?

First, with open source code and open standards. We have some already. Llama 3, from Meta AI, is “your own intelligent assistant,” and positions Meta as a more open and user-friendly cow than OpenAI. Meta is still on the top-down Big Tech side of the war we’re in. But hell, we can use what they’ve got. So let’s play with it.

Here on the ground there are all these (with quotage lifted from their sites or reviews such as this one)—

  • MindsDB: “an open-source AutoML framework”
  • Alt.ai: “It’s an A.I. which aims to digitize users’ intentions and place it on the cloud to let our clones deal with all digital operations.”
  • Keras: “a multi-backend deep learning framework, with support for JAX, TensorFlow, and PyTorch”
  • PyTorch: “Python package that provides two high-level features: Tensor computation (like NumPy) with strong GPU acceleration, and Deep neural networks built on a tape-based autograd system
  • Tensor Flow: “open-source framework for machine learning”
  • CoreNet: a deep neural network toolkit for small and large-scale models, from Apple
  • Haystack: an “open source Python framework by deepset for building custom apps with large language models (LLMs).”
  • Image Super-Resolution (ISR): “(an) open source tool employs a machine learning model that you can train to guess at the details in a low-resolution image:
  • Blender: “A rich interface and numerous plugins make it possible to create complex motion graphics or cinematic vistas”
  • DeepFaceLab: “open source deepfake technology that runs on Python”
  • tflearn: “an advanced deep learning library”
  • PYTensor: “a Python library that allows you to define, optimize/rewrite, and evaluate mathematical expressions involving multi-dimensional arrays efficiently.” (Was Theano)
  • LM Studio: “Discover, download, and run local LLMs”
  • HuggingFace Transformers: “a popular open-source library for Natural Language Processing (NLP) tasks”
  • Fast.ai: “a library for working with deep learning tasks”
  • OpenCV: “a popular Computer Vision and Image Processing library developed by Intel”
  • Detectron2: “a next-generation library that provides advanced detection and segmentation algorithm” and “a PyTorch-based modular object detection library”
  • Ivy.ai: “an open-source deep learning library in Python focusing on research and development”
  • OpenAssistant: “a project aimed at giving everyone access to a great chat-based large language model”
  • PaddleNLP: “a popular open source NLP library that you can use to glean search sentiment and flag important entities”
  • Delphi.AI: “Clone yourself. Build the digital version of you to scale your expertise and availability, infinitely.”
  • Fauxpilot: “This is an attempt to build a locally hosted alternative to GitHub Copilot. It uses the SalesForce CodeGen models inside NVIDIA’s Triton Inference Server with the FasterTransformer backend.”
  • Ray: “An open source framework to build and scale your ML and Python applications easily”
  • Solid: “Solid is a specification that lets individuals and groups store their data securely in decentralized data stores called Pods. Pods are like secure web servers for data. When data is stored in a Pod, its owners control which people and applications can access it.”
  • Sagen.ai: “Your very own AI Personal Assistant to manage your digital life.”
  • YOLOv7: “is one of the fastest and most accurate open source object detection tools. Just provide the tool with a collection of images full of objects and see what happens next.”

—and lots of others that readers can tell me about. Do that and I will add links later. This is a work in progress.

Below all of those we still need something Linux-like that will become the open base on which lots of other stuff runs. The closest I’ve seen so far is pAI-OS, by Kwaai.ai, a nonprofit I now serve as Chief Intention Officer. I got recruited by Reza Rassool, Kwaai’s founder and chair, because he believes personal AI is required to make The Intention Economy finally happen. So that was a hard offer to refuse. Kwaai also has a large, growing, and active community, which I believe is necessary, cool, and very encouraging.

As with most (maybe all) of the projects listed above, Kwaai is a grass-roots effort by human beings on the natural, human, and horizontal side of a battle with giants who would rather give us personalized AI than have us meet them in a middle to which we will bring personal AI powers of our own. In the long run, we will meet in that middle, because personal AI will be better for everyone than personalized AI alone.

Watch us prove it. Better yet, join the effort.


*I am indebted to Lavonne Reimer for introducing and co-thinking the horizontal vs. vertical frame, and look forward eagerly to her own writings and lecturings on the topic.
🔲 ☆

Open source : comment Sinequa facilite l’accès aux données de la NASA

Si l’an passé, la NASA a déclaré 2023 “l’année de l’open source”, elle a toujours fait de l’accès à ses recherches une priorité. Pour faciliter le partage de ses données, la Direction des missions scientifiques (SMD) de la NASA a lancé la version bêta du moteur Science Discovery Engine, optimisée par la plateforme de Sinequa, un leader du marché de la recherche et de l’analyse de données basées sur l’IA.

Cofondé en 2005 par Jean Ferré et Alexandre Bilger, Sinequa permet aux entreprises de tirer de la valeur de la masse de données dont elles disposent. Sa solution, combinant un moteur de recherche puissant (Enterprise Search) avec des fonctionnalités avancées de traitement du Langage Naturel (NLP) et des algorithmes d’apprentissage automatique, permet d’extraire des informations métiers à partir de données structurées, mais également non structurées. La société a été l’une des premières à inclure les grands modèles de langage (LLM) dans la recherche.

Le Science Discovery Engine de la NASA

Le SDE est un élément clé du programme Open Source Science Initiative (OSSI) de la NASA qui vise à rendre la recherche scientifique financée par des fonds publics transparente, inclusive, accessible et reproductible et de son initiative “Transform to Open Science” (TOPS) dont l’objectif est de créer une culture inclusive de la science ouverte capable de relever les défis du 21e siècle.

En 2019, la communauté scientifique recommandait à la NASA de développer un portail de recherche qui donnerait, à partir d’une seule interface, accès au contenu des cinq domaines scientifiques de la SMD : astrophysique, sciences biologiques et physiques, sciences de la Terre, héliophysique et sciences planétaires.

En 2020, la solution Enterprise Search de Sinequa a été sélectionnée pour aider la NASA à accéder à des informations accumulées depuis plusieurs décennies, ainsi qu’à les exploiter de façon optimale. La collaboration étroite amorcée alors entre l’équipe de Sinequa et les développeurs, chercheurs et data scientists de la NASA a abouti à la création du SDE.

Un ensemble de données hétérogènes

Pour mettre en œuvre ce moteur de recherche, les partenaires ont du relever un défi de taille, outre la quantité des données : leur hétérogénéité et leur complexité, chacun ses 5 domaines opérant avec ses propres normes et terminologies.

Aujourd’hui, les utilisateurs du SDE peuvent extraire des informations enregistrées de plus de 84 000 ensembles de données et plus de 715 000 documents, répartis dans 128 sources d’information différentes, sites internet, référentiels de données et archives documentaires. Egalement intégrée à plus de 44 500 logiciels, modèles et outils scientifiques, la solution de Sequina reconnait plus de 8 900 termes scientifiques différents, un nombre qui devrait augmenter prochainement.

La nouvelle interface utilisateur

La version bêta du SDE a été lancée en décembre 2022. Depuis lors, l’interface n’a cessé d’être améliorée afin d’offrir des résultats de recherche plus pertinents, une nouvelle version a ainsi été mise en ligne en janvier dernier.

Kaylin Bugbee, chef de projet SDE, explique :

“Les scientifiques et les chercheurs passent beaucoup de temps à rechercher et à démêler des données et des informations scientifiques. Les nouvelles mises à jour de l’interface utilisateur de SDE font gagner du temps aux chercheurs en les aidant à rechercher rapidement des données et de la documentation par sujet scientifique ou dans l’ensemble de la collection d’informations. Cette amélioration de l’efficacité de la recherche permet aux scientifiques d’accéder plus rapidement à une science ouverte et exploitable”.

Désormais, des fonctionnalités de filtrage supplémentaires offrent aux utilisateurs la possibilité d’effectuer des recherches spécifiques dans un domaine scientifique donné, tel que la science planétaire ou l’héliophysique, simplifiant ainsi leurs processus de recherche. Parmi les mises à jour figure également un nouvel outil de recherche par acronyme, permettant une meilleure compréhension du contexte des résultats de recherche et du contenu des documents.

La NASA prévoit d’intégrer davantage de données et de contenus au cours des mois à venir, notamment en enrichissant les fonctionnalités de l’interface utilisateur et en poursuivant le développement de l’API du moteur. L’équipe du SDE prévoit de son côté un déploiement complet de l’outil à l’automne 2024.

Jean Ferré, CEO de Sinequa, conclut :

“Le Science Discovery Engine est une infrastructure fantastique qui aide les scientifiques de la NASA, ainsi que les utilisateurs du monde entier, à trouver les informations dont ils ont besoin en quelques secondes seulement, au lieu de plusieurs minutes, voire de longues heures. Nous sommes fiers d’aider la NASA à transformer et à améliorer la productivité dans l’ensemble de son organisation et serons à ses côtés pour associer de nouveaux ensembles de données et de nouvelles sources d’informations qui alimenteront son moteur de connaissances. Pour la science, la technologie et l’innovation, le partage de données scientifiques et ouvertes constitue le seul moyen de prospérer. À cet égard, Sinequa se réjouit de jouer un rôle actif dans cette initiative”.

Open-source-comment-Sinequa-facilite-donnees-NASA
🔲 ☆

EB corbos Linux – Le premier OS open source certifié pour l’automobile

Figurez-vous qu’Elektrobit, le géant allemand de l’électronique automobile, vient de nous pondre un truc qui va faire plaisir aux fans de libre : EB corbos Linux, le premier système d’exploitation open source qui respecte les normes de sécurité les plus pointues du monde de la bagnole.

En gros, les constructeurs en ont marre de se trimballer des kilomètres de câbles et des centaines de boîtiers noirs dans leurs caisses-. L’idée, c’est de tout centraliser sur quelques « super ordinateurs » qu’ils appellent des « plateformes de calcul haute performance ». Et chacun gère son domaine : la conduite, l’info-divertissement, les aides à la conduite… Bref, ça simplifie le bordel et ça permet de faire évoluer les fonctionnalités sans toucher au hardware.

Le hic, c’est que tout ce bazar logiciel doit être hyper sécurisé. Parce que si votre autoradio plante, c’est pas bien grave, mais si c’est votre direction assistée qui décide de partir en vacances, bonjour les dégâts ! C’est là qu’EB corbos Linux entre en scène.

Grâce à son architecture unique, ce système d’exploitation prend Linux et le rend compatible avec les exigences les plus draconiennes en matière de sécurité automobile, genre les normes ISO 26262 et IEC 61508 en utilisant un hyperviseur et un système de monitoring externe qui valide les actions du noyau. En gros, Linux peut continuer à évoluer tranquillou sans compromettre la sécurité.
Comme cette distrib est basé sur du bon vieux Linux, il profite de toute la puissance de l’open source. Genre les milliers de développeurs qui bossent dessus, les mises à jour de sécurité en pagaille, la flexibilité, la rapidité d’innovation… Tout ça dans une distrib’ véhicule-compatible, c’est quand même cool. En plus, Elektrobit a développé ce petit miracle main dans la main avec l’équipe d’ingénieurs d’Ubuntu Core chez Canonical. Autant dire que c’est du lourd !

Elektrobit a pensé à tout puisqu’ils proposent même une version spéciale pour les applications critiques, genre les trucs qui peuvent tuer des gens s’ils plantent. Ça s’appelle EB corbos Linux for Safety Applications, et c’est le premier OS Linux à décrocher la certification de sécurité automobile auprès du TÜV Nord.

Mais le plus cool, c’est qu’avec cet OS, vous pouvez laisser libre cours à votre créativité de développeur automobile. Vous voulez intégrer les dernières technos de conduite autonome, d’intelligence artificielle, de reconnaissance vocale… Pas de problème, Linux a tout ce qu’il faut sous le capot.
Imaginez que vous bossiez sur un système de reconnaissance de panneaux pour aider à la conduite. Avec ça, vous pouvez piocher dans les bibliothèques open source de traitement d’image, de machine learning, etc. Vous adaptez tout ça à votre sauce, en respectant les contraintes de sécurité, et voilà ! En quelques sprints, vous avez un truc qui déchire, testé et approuvé pour la route. Et si un autre constructeur veut l’utiliser, il peut, c’est ça la beauté de l’open source !
Autre exemple, vous voulez développer un système de monitoring de l’état de santé du conducteur, pour éviter les accidents dus à la fatigue ou aux malaises. Là encore, EB corbos Linux est votre allié. Vous pouvez utiliser des capteurs biométriques, de l’analyse vidéo, des algorithmes de détection… Tout en étant sûr que votre code ne mettra pas en danger la vie des utilisateurs.

Bref, vous l’aurez compris, c’est le meilleur des deux mondes avec d’un côté, la puissance et la flexibilité de Linux, de l’open source, de la collaboration à grande échelle et de l’autre, la rigueur et la sécurité indispensables au monde automobile, où la moindre erreur peut coûter des vies.

Source

🔲 ☆

L’IA générative au sein des services publics : Gabriel Attal dévoile Albert, un modèle de la DINUM

Ce sont les maisons France Services qui ont expérimenté les premières le LLM Albert. Gabriel Attal, en visite dans l’une d’elles à Sceaux, a annoncé ce mardi 23 avril 2024 le prochain déploiement au sein des services publics de ce modèle d’IA souverain, puisque développé par et pour des agents publics français.

Il y a un an, en mai 2023, le gouvernement annonçait une expérimentation visant à mettre l’IA générative au service des agents et usagers du service public, officialisée en octobre suivant par Stanislas GUERINI, Ministre de la Transformation et de la Fonction publiques.

L’expérimentation de l’IA générative au sein des services publics : un temps de réponse divisé par 2

Le mois de septembre précédent, mille agents de la CNAV (Caisse Nationale d’Assurance Vieillesse), Pôle Emploi ou l’Assurance Maladie ont testé un modèle adapté par la start-up française AlloBrain, du LLM Claude d’Anthropic, pour répondre aux commentaires laissés par les usagers sur le site Services-publics.fr.

Les premiers résultats de l’expérimentation, menée par la DITP et la Direction Interministérielle du Numérique (DINUM), se sont avérés très concluants :

  • Dans les services publics volontaires, 1 réponse sur 2 a été facilitée par l’IA ;
  • Le temps de réponse moyen est passé de 7 jours à 3 jours ;
  • Au bout de 2 mois, 70% des agents ont un ressenti positif de l’utilisation de l’outil et 74% des usagers se sont dits satisfaits de la réponse apportée.

Albert, un modèle souverain open source spécialisé en interne

La DINUM travaille depuis juin  2023 au développement d’Albert, un modèle interne. En octobre dernier, Ulrich Tan, ingénieur polytechnicien, Chef du pôle Datalab du département Etalab de la Direction interministérielle précisait que ce modèle allait reposer sur “des briques technologiques, des intelligences artificielles pré-entraînées et disponibles en open source”, comme Llama ou Falcon,  optimisées grâce au fine-tuning pour les besoins des agents du service public. Les modèles open source de Mistral AI lancés à partir de fin septembre auraient également contribué au développement d’Albert.

Créé par et pour des agents publics, cet outil d’IA générative souverain, libre et ouvert, devait être déployé auprès de conseillers volontaires du réseau France services avant de l’être dans d’autres services publics, ce que vient de confirmer Gabriel Attal :

“Je vous annonce que nous avons développé une intelligence artificielle souveraine, française, qui va révolutionner nos services publics et que nous mettons désormais au service des Français”.

Mentionnant les travaux d’Ulrich Tan et ses collaborateurs au sein du Datalab, il a ajouté :

“Grâce à eux, la France est le premier pays européen à inaugurer une IA 100% souveraine et à la mettre au service de ses services publics”.

Le 7 février dernier, la DINUM a reçu le prix “innovation” lors des Victoires des Acteurs publics, un événement organisé par le média Acteurs Publics sous le haut patronage de la présidence de l’Assemblée nationale, pour le lancement d’Albert.

Albert France Services

Chaque mois, les conseillers des 2700 guichets uniques du réseau France Services doivent répondre à près de 800 000 démarches des Français, parfois très complexes.

La version spécifique du réseau “Albert France services”, grâce à un moteur de réponse en langage naturel, leur facilite l’accès aux informations en leur générant une réponse adaptée à la situation de l’usager qu’il accompagne.

Albert fournit au conseiller une réponse rédigée spécifique à la question posée, mais également :

  • Les sources sur lesquelles il s’est appuyé pour produire la réponse ;
  • Une liste d’autres questions fréquemment posées en lien avec la réponse ;
  • Des liens pratiques (téléservices, simulateurs …) ;
  • Des fiches pratiques issues de service-public.fr.

Le conseiller a ensuite la liberté d’utiliser ou non les réponses suggérées ou de les adapter. Comme le souligne le Premier ministre, le but n’est pas de remplacer les agents publics mais de leur permettre de dégager plus de temps pour les relations humaines :

 “A l’IA les tâches rébarbatives, et aux agents publics, le lien avec nos concitoyens”.

ia-generative-services-publics
🔲 ☆

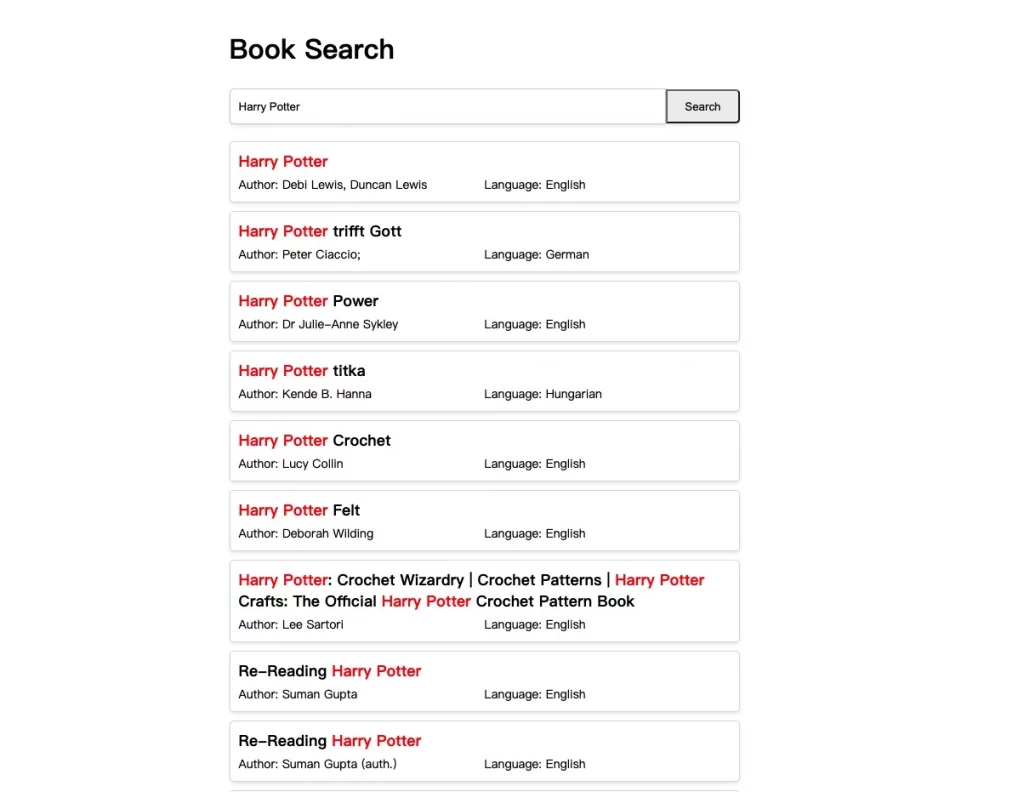
Ebook-demo – Le moteur de recherche de bouquins décentralisé

Vous en avez ras le bol de chercher pendant des heures le bouquin que vous voulez lire sans le trouver dans le commerce ? Pourquoi ne pas le télécharger en ligne alors ? Mais oùùùù ?

Et bien, j’ai peut-être une solution pour vous les amis et ça s’appelle sans chichi ebook-demo, un nouveau projet de moteur de recherche décentralisé pour les livres électroniques, inspiré de Liber3 (qui est un projet aux sources fermées).

Imaginez un peu le truc : vous tapez le titre du livre que vous cherchez dans la barre de recherche, vous cliquez sur « Search » et BAM, les résultats s’affichent juste en dessous avec le titre et l’auteur de chaque bouquin correspondant. C’est simple, efficace et ça marche du tonnerre !

Mais attendez, c’est pas tout. Ce qui rend ce projet encore plus cool, c’est qu’il est basé sur des technologies comme React et le SDK Glitter (pour la blockchain du même nom qui sert de base de données décentralisée).

Bon, je vois déjà les petits malins qui se disent « Ok, c’est bien beau tout ça, mais comment ça s’installe concrètement ?« . Pas de panique, c’est là que ça devient un peu technique mais je vais essayer de vous expliquer ça simplement. Déjà, pour faire tourner ce projet sur votre machine, il vous faudra avoir installé Node.js en version 16.x minimum et npm en version 6.x minimum. Ensuite, vous devrez cloner le dépôt du projet depuis GitHub avec la commande

git clone https://github.com/j2qk3b/ebook-demo

puis vous placer dans le dossier du projet avec

cd ebook-demo

Là, vous lancez un petit

npm install

pour installer toutes les dépendances nécessaires et vous êtes prêt à démarrer le serveur de développement avec

npm run dev

Et voilà, si tout se passe bien, vous devriez pouvoir accéder à l’application sur http://localhost:5173.

Fastoche, non ? Ensuite, votre instance ira se connecter aux autres instances, et vous pourrez faire toutes les recherches qui vous passent par la tête. Imaginez un peu les possibilités offertes par un tel outil. Vous êtes étudiant et vous devez faire des recherches pour un mémoire sur la littérature française du 19ème siècle ? Pas de souci, en quelques clics vous pouvez retrouver les œuvres de Victor Hugo, Balzac ou Zola. Ou alors vous êtes un fan absolu de science-fiction et vous voulez découvrir de nouveaux auteurs ? Là encore, ce moteur de recherche sera votre meilleur ami pour dénicher les pépites du genre.

Mais le plus beau dans tout ça, c’est que ce projet est open source et que tout le monde peut y contribuer. Si vous avez des idées pour améliorer l’outil, des suggestions de nouvelles fonctionnalités ou même si vous voulez corriger des bugs. Puis comme c’est décentralisé, c’est le genre de truc incensurable.

Évidemment, comme tout projet en développement, il y a encore du boulot pour faire de ebook-demo l’outil ultime de recherche de livres électroniques. Mais avec une communauté motivée et des contributeurs talentueux, je suis sûr qu’il peuvent y arriver.

🔲 ☆

Llama 3 – l’IA open source de Meta qui rivalise avec les meilleurs modèles

Accrochez-vous à vos claviers, car Meta vient de lâcher dans la nature une nouvelle créature nommée Llama 3. Oui, vous avez bien compris, je parle de la dernière génération de modèles de langage « open source » (ou presque, on y reviendra) de la société de Mark Zuckerberg.

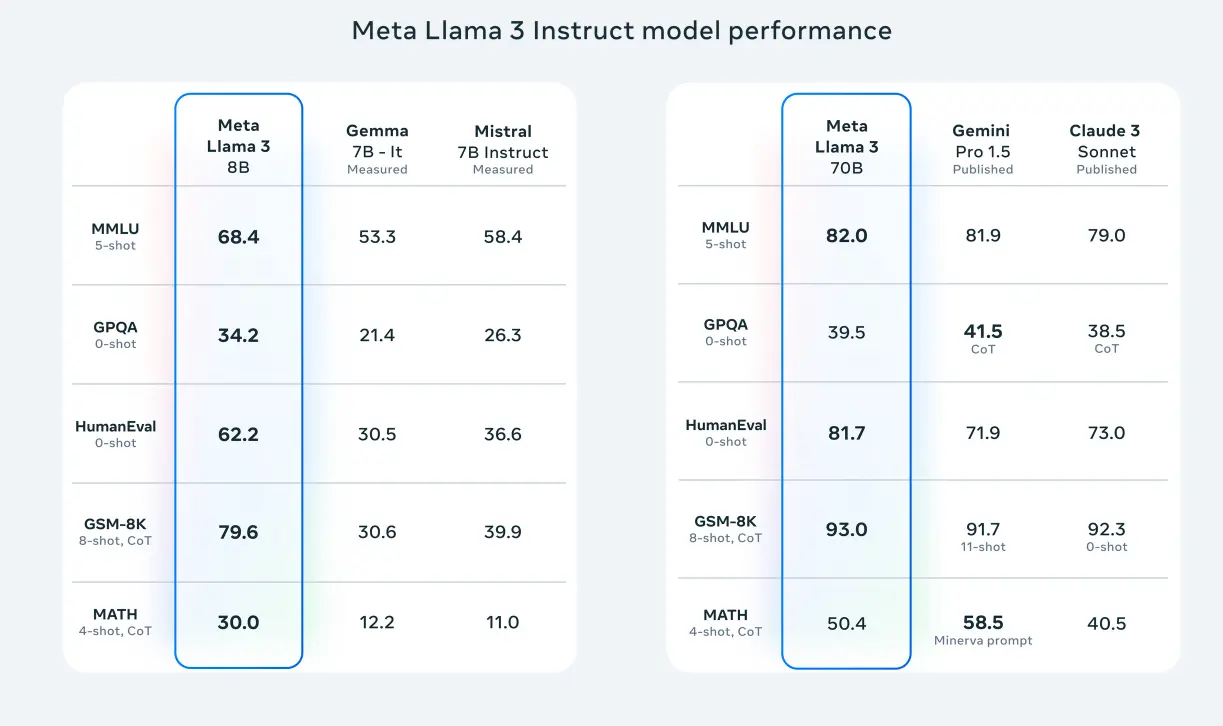
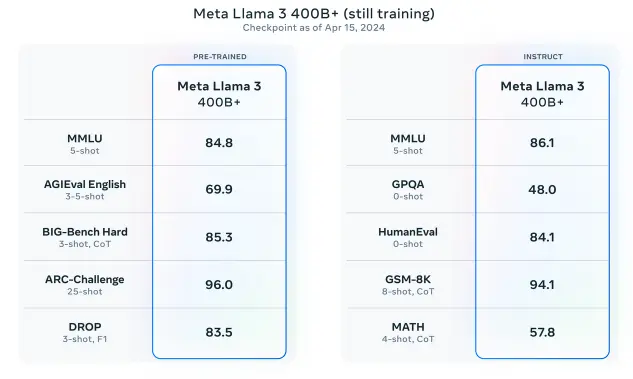
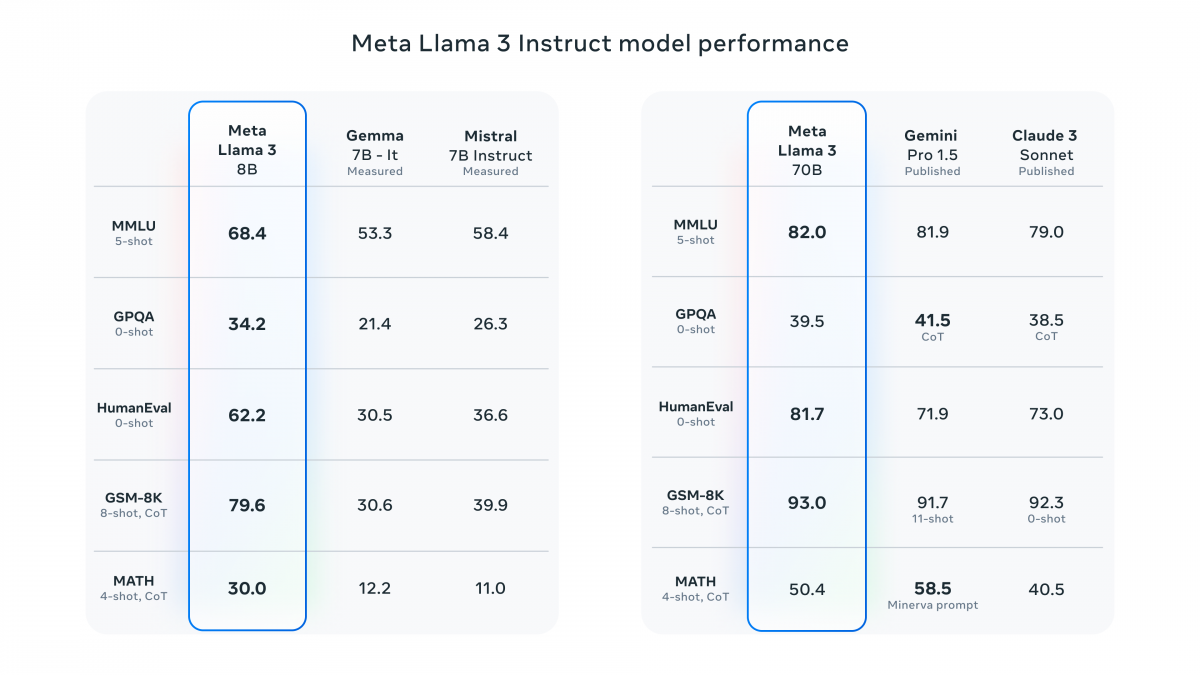
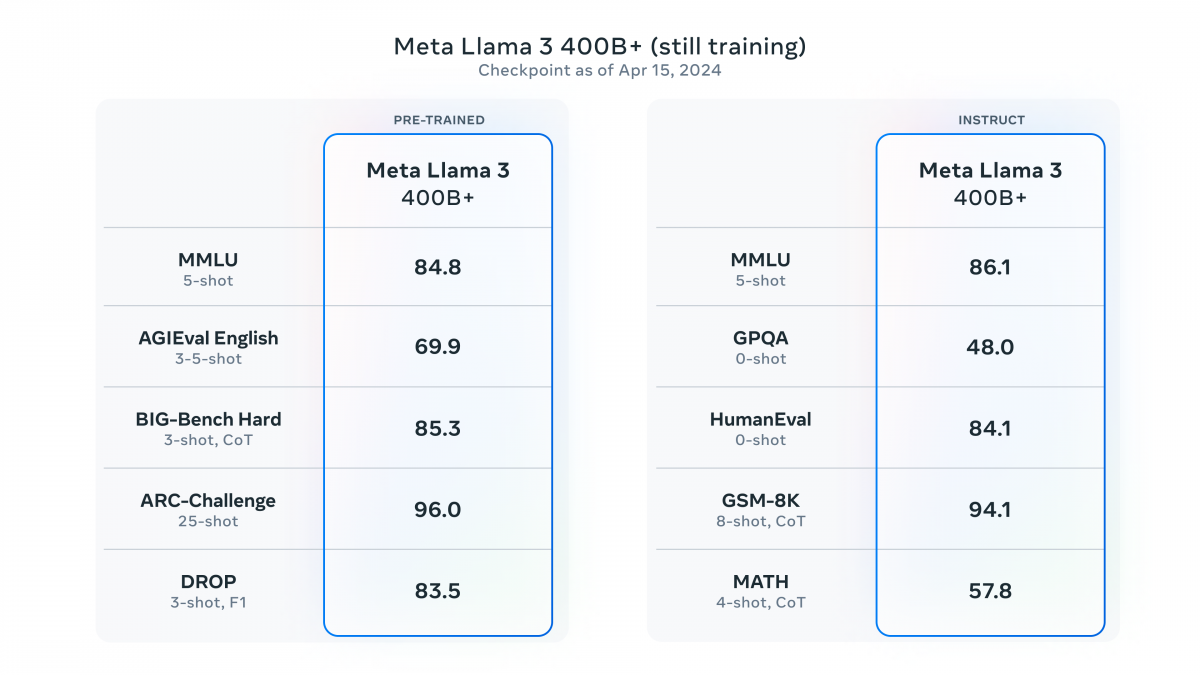
Si vous pensiez que ChatGPT, Claude ou Mistral étaient les rois de la savane, attendez de voir débarquer ces nouveaux lamas survitaminés ! Avec des versions allant de 8 à 400 milliards de paramètres (pour les non-initiés, disons que c’est l’équivalent de leur QI 🧠), les Llama 3 atomisent littéralement la concurrence sur de nombreux benchmarks standards, que ce soit en termes de connaissances générales, de compréhension, de maths, de raisonnement ou de génération de code.

Mais qu’est-ce qui fait de Llama 3 un tel monstre par rapport à son petit frère Llama 2 ? Déjà, un entraînement de folie à base de 15 000 milliards de tokens (7 fois plus que Llama 2 !) pompé depuis le web (!!), avec beaucoup plus de code et de données non-anglaises pour préparer le terrain à une IA multilingue. Ajoutez à ça des techniques de parallélisation à gogo pendant la phase de pré-entraînement, et vous obtenez des lamas dopés qui apprennent à une vitesse supersonique.

Et ce n’est pas tout ! Les Llama 3 ont suivi un programme d’éducation complet, avec du fine-tuning à base de rejection sampling, de PPO et de DPO (si vous ne connaissez pas ces acronymes, ne vous inquiétez pas, moi non plus 😅). Résultat : des modèles ultra-fiables qui refusent rarement une tâche, font preuve d’un alignement exemplaire et sont capables de suivre des instructions complexes sans sourciller. Bref, ce sont des cracks en raisonnement et en génération de code !

Mais au fait, comment on met la main sur ces petites bêtes ? Facile, il suffit de se rendre sur le site de Meta AI et de les télécharger ! Enfin, quand je dis facile… Les Llama 3 sont bien « open source », mais sous une licence maison qui impose quelques restrictions, notamment pour les entreprises de plus de 700 millions d’utilisateurs mensuels (suivez mon regard vers Mountain View et Redmond 👀). Mais bon, rien ne vous empêche de vous amuser avec si vous n’êtes pas une multinationale !

Et en parlant de s’amuser, sachez que Meta a aussi concocté un chatbot maison (pas encore dispo en France) baptisé sobrement « Meta AI« , disponible sur le web (www.meta.ai) et directement intégré dans les barres de recherche de Facebook, Instagram, WhatsApp et Messenger. Sous le capot, c’est bien sûr du pur Llama 3, avec en prime un modèle de génération d’images nommé « Meta Imagine« .

Au programme, de la discussion, de la recherche web via Bing et Google, et bien sûr de la création d’images en un clin d’œil. Seul hic, pas encore de mode multi-modal façon ChatGPT pour uploader vos propres documents ou images, mais ça ne saurait tarder !

Alors, que penser de ce nouveau coup d’éclat de Meta dans la bataille des IA ?

Personnellement, je trouve ça plutôt chouette de voir un poids lourd du Net jouer le jeu de l’open source (ou approchant) et mettre à disposition de tous des modèles de cette qualité. Bien sûr, on peut toujours discuter des arrière-pensées de Zuck et sa volonté de garder un œil sur ce qu’on fabrique avec ses lamas. Mais au final, c’est toujours ça de pris sur les GAFAM et leurs vilains modèles propriétaires !

Allez, je vous laisse, j’ai un lama à aller dompter moi ! 🦙

Et n’oubliez pas, comme le dirait l’autre, « le monde appartient à ceux qui codent tôt ». Ou tard, c’est selon.

Source

🔲 ☆

Meta dévoile les deux premiers modèles de la famille Llama 3

Comme attendu, Meta a partagé hier deux premiers modèles de la famille Llama 3 : Llama 3 7B et Llama 3 70B, qui seront suivis dans les prochains mois par des modèles allant jusqu’à 400 milliards de paramètres. Ces deux modèles open source, d’ores et déjà intégrés dans son assistant Meta AI disponible sur ses réseaux sociaux dans certains pays anglophones, sont présentés par Meta comme les meilleurs modèles existants à leur échelle. 

Selon la société, les améliorations apportées par rapport à Llama 2 ont considérablement réduit les taux de faux refus, perfectionné l’alignement et accru la diversité des réponses. Llama 3 présente en outre des capacités de raisonnement et de génération de code améliorées.

Meta a comparé les performances de ces modèles dans les benchmarks de référence Llama 3 7B avec Gemma de Google, Mistral 7 B de Mistral AI, et Llama 3 70 B avec Gemini Pro 1,5 de Google et Claude 3 Sonnet d’Anthropic.


L’ensemble de données de pré-entrainement de Llama 3 totalise plus de 15 téraoctets de jetons de données publiques, soit 7 fois plus que celui de Llama 2 et comprend quatre fois plus de code. Pour anticiper les futurs cas d’utilisation multilingues, plus de 5 % de ces données ne sont pas anglaises, couvrant plus de 30 langues. Même si elles sont de haute qualité, Meta reconnaît que les performances dans ces langues peuvent varier par rapport à l’anglais.

Des améliorations ont également été apportées au niveau architecture. Llama 3 utilise un tokenizer avec un vocabulaire de 128 000 jetons qui encode le langage beaucoup plus efficacement. Pour optimiser le processus d’inférence des modèles Llama 3, l’approche d’attention des requêtes groupées (Group Query Attention ou GQA) a été mise en œuvre pour les versions de 8B et 70B. Les modèles ont été entraînés sur des séquences de 8192 tokens, avec l’application d’un masque spécifique assurant que l’attention accordée reste confinée aux frontières du document.

Les deux modèles seront bientôt disponibles sur AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM et Snowflake.

Meta annonce pour les prochains mois plusieurs modèles multimodaux, avec une prise en charge de plusieurs langues, une fenêtre contextuelle plus longue, ainsi que des capacités globales plus robustes. Il donne un aperçu de Llama 3 400B, le plus grand modèle de la famille dont il poursuit l’entraînement.

Les poids de Llama 3 et le générateur de jetons sont téléchargeables sur GitHub.

Meta dévoile les deux premiers modèles de la famille Llama 3
❌