BigQuery adds first-party support for Delta Lake
6 juin 2024 à 04:42
BigQuery, now with first-party support for Delta Lake, grows Delta Lake’s vibrant connector ecosystem and simplifies its integration with Databricks.


Aujourd’hui, j’aimerai vous parler OpenCat, un framework open source qui va vous aider à créer vos propres robots animaux de compagnie, c’est à dire des quadrupèdes hyper réalistes et Ô surprise parfaitement abordables. Pour cela, OpenCat permet de piloter des servomoteurs haute performance utilisés comme articulations, une structure de corps optimisée et des contrôleurs low-cost comme Arduino, ESP32 ou Raspberry Pi.
Vous pouvez également ajouter plein de modules trop cools comme une caméra intelligente, des capteurs IoT ou encore une commande vocale. Avec le code de contrôle open source hyper efficace, vos robots vont littéralement prendre vie !
OpenCat, c’est pas non plus juste un délire de geek barbu puisque ça a déjà été déployé sur des robots commerciaux comme le chat Nybble et le chien Bittle de Petoi. Ces petites merveilles de technologie peuvent courir, marcher et même s’auto-équilibrer comme de vrais animaux.
Les créateurs d’OpenCat partagent tout ça en open source pour une bonne raison : Ils veulent favoriser la collaboration dans le développement de la robotique, de l’IoT et de l’IA sur des robots quadrupèdes abordables. Ils veulent également diffuser des ressources éducatives sur la robotique au plus grand nombre et inspirer les étudiants, les ados et même les enfants. C’est beau quand même !
Bref, si vous aussi vous rêvez de construire vos propres robots animaux de compagnie, foncez sur OpenCat ! C’est le moment de mettre les mains dans le cambouis, d’apprendre en s’amusant et de participer à cette aventure.
Vous rêvez de vous initier au monde de la robotique et de l’intelligence artificielle ?
Ca tombe bien puisque ce kit RaspRover va vous permettre de réaliser ce doux rêve ! Ce petit robot 4×4 hyper versatile est le compagnon idéal pour partir à l’aventure car il embarque un Raspberry Pi dernière génération (modèles 4 ou 5) ce qui va vous permettre de laisser libre cours à votre créativité en le programmant vous-même.
Et pas besoin d’être un crack en informatique pour dompter ce robot puisque tout est pensé pour faciliter sa prise en main. En effet, sous le capot, vous trouverez un double contrôleur avec d’un côté le Raspberry Pi qui gère les fonctions IA de haut niveau pendant que de l’autre, un microcontrôleur se charge des opérations basiques à haute fréquence. Comme ça, chaque action que vous lui demandez est précise et fluide.
Côté perception, le RaspRover a du flair grâce à sa caméra mobile grand angle qui lui offre une vision périphérique à 160°. Couplée à l’IA de reconnaissance d’images de OpenCV, cette caméra détecte et piste les visages ou les objets. Bref, de quoi lui permettre d’interagir avec son environnement sans souci.
Et ce n’est pas tout puisqu’il dispose d’une panoplie de capteurs (IMU 9 axes, télémètre laser…) qui décuplent ses talents : cartographie, évitement d’obstacles, localisation précise… et son architecture modulaire et ses nombreuses interfaces (GPIO, USB, I2C, UART…) lui permettent d’accueillir une foule d’accessoires : bras robotique, capteurs environnementaux, module 4G/5G… De quoi l’adapter à une infinité de scénarios comme de l’agriculture de précision, l’inspection de sites industriels, de la télé-surveillance, pour l’éducation, la recherche…
Et bien sûr, il carbure à l’open source ce qui veut dire que vous pouvez personnaliser son code et ajouter vos propres fonctionnalités. De plus, grâce au protocole ESP-NOW, plusieurs RaspRover peuvent même communiquer et collaborer entre eux ! Imaginez l’escouade de robots que vous allez pouvoir programmer avec ce truc.
Si ça vous dit, y’a un super Wiki qui vous explique comment monter et programmer tout ça.
There is a war going on. Humanity and nature are on one side and Big Tech is on the other. The two sides are not opposed. They are orthogonal. The human side is horizontal and the Big Tech side is vertical.*
The human side is personal, social, self-governed, heterarchical, open, and grounded in the physical world. Its model is nature, and the cooperative contexts in which competition, creation, and destruction happen in the natural world.
The Big Tech side is corporate, industrial, hierarchical, competitive, mechanistic, extractive, and closed, even though it produces many positive-sum products and services that are good for people and good for nature. It is also, being competitive and rewarding toward winner-take-most outcomes, dominated by giants.
This war has been fought over many other things in the past, especially in tech. But AI is the big one right now—and perhaps the biggest one of all time.
Over the long run, both sides will win, because we need the best of what both bring to the world’s big round table. In the past, this has happened in countless markets, countries, polities, societies, and other contexts. In tech it happened with the conflict between PCs and mainframes, between the open and public Internet and closed private networks, and between open operating systems and closed ones. None of those conflicts have final outcomes, but they have arrived at stable and cooperative states. They arrived at those states because everyone recognized that people can do more with their own tools than those big entities can do on theirs, or by using people as extracted resources.
This conflict is perhaps best represented by the ironies that have been at work within OpenAI and Sam Altman, its prior and current CEO. We can also see it with sparkling clarity in something amazing that Sam said near the close of his keynote at the first OpenAI Developer Conference, in November of last year:
Lets unpack that.
Individual empowerment means exactly what it says. Agency is the ability to take action or to choose what action to take (Cambridge Dictionary). Scale means growth toward ubiquity.
You have individual empowerment and agency when you ride your bike, drive your car, mow your lawn, or button your shirt. You also have it when you work on your laptop, phone, and other smart rectangles. Scale means your power and agency will grow to the max while the same will happen for nearly everyone else. Scale for you alone won’t cut it. When most of us have it, that’s scale.
Technologies extend us. They enlarge our capacities in the world. Intelligence is one of those capacities. So is memory. Your rectangles help a lot with both. That’s why those have already scaled to ubiquity, or close enough.
AI will do the same, but only if it’s personal. Not if it’s just “personalized.”
As Jamie Smith made clear here a year ago, “your personal AI isn’t really personal.”
ChatGPT4 doesn’t know that yet. I can tell because I just asked:
Me:
What is “personal AI”?ChatGPT4:
“Personal AI” refers to artificial intelligence systems that are designed to serve individual users through personalized interactions and services. These AI systems learn from the specific preferences, behaviors, and needs of their users to offer more tailored assistance, recommendations, or information. The goal of personal AI is to enhance user experience by adapting to unique personal profiles.There are various applications of personal AI, including:
- Virtual Assistants: Like Siri, Google Assistant, and others, these AIs help with daily tasks such as scheduling, reminders, searching information, and controlling smart home devices, all customized to the user’s habits and preferences.
- Recommendation Systems: Used in streaming services like Netflix or shopping platforms like Amazon, these AI systems analyze your past behavior to recommend movies, shows, or products you might like.
- Healthcare: Personal AI can track individual health metrics and provide personalized advice, monitor conditions, or even alert medical professionals if needed.
- Learning and Development: In education, personal AI can adapt learning materials to the pace and learning style of the student, offering a customized educational experience.
- Gaming: AI in gaming can adapt to provide a challenge tailored to the player’s skill level or alter the game narrative based on choices made by the player.
The development of personal AI focuses on enhancing user engagement by creating more intuitive and responsive interactions that feel uniquely suited to each individual.
For a second opinion, I asked Google’s Gemini the same question.
Me:
What is “personal AI”?Gemini:
Personal AI refers to artificial intelligence designed to assist and interact with a specific individual. It’s essentially your own AI companion that learns about you and tailors its services to your needs. Here are some key aspects of personal AI:
- Personalization: Unlike general-purpose AI assistants, personal AI focuses on you. It learns from your interactions, preferences, and habits to become more helpful over time.
- Focus on Memory and Knowledge: Some personal AI systems aim to become an extension of your mind. They can store your memories, knowledge, and experiences, making them readily accessible and even usable to help with tasks like writing or communication.
- Varied Applications: Personal AI can have a wide range of applications. Imagine an AI that helps you:
- Organize your life: Manage schedules, appointments, and reminders.
- Boost productivity: Assist with tasks, research, and communication.
- Enhance creativity: Help you brainstorm ideas or generate creative content.
- Improve learning: Personalize learning experiences and provide targeted information.
Privacy Concerns: Storing personal data on an AI raises concerns about privacy and security.
Overall, personal AI holds promise for a future where technology seamlessly integrates with our lives, offering personalized assistance and support.
To both companies, personal AI is a personalized service—from them. It’s not something you own and control. It’s not about individual empowerment and agency. It doesn’t extend you. It’s hired prosthesis: an extension of them rather than of you.
Let’s name the category: AIaaS—AI as a Service.
But hats off. OpenAI and Gemini do amazing jobs. So do lots of other AI services by wannabe giants. I use AI every day to improve what I write, to generate and fix images, to answer questions that old-fashioned search engines can’t answer or suck at. I even pay extra for some of it (such as ChatGPT4 and Adobe’s Creative Suite). And it seems they all get better, all the time, at everything. Won’t personalization be good enough, eventually?
No. Because they aren’t you. They also aren’t yours, so they can’t extend you. They can seem to. But they don’t. They also don’t have access to most of your private life. Nor should they.
But your private life could use some AI help. For example—
It’s not easy to visualize what a personal AI might do for those, but let’s try. Here’s how Microsoft’s Copilot (or whatever it’s called this week) did it for me before I got rid of all its misspellings and added my own hunks of text:
All that stuff is data. But most of it is scattered between apps and clouds belonging to Apple, Google, Microsoft, Amazon, Meta, phone companies, cable companies, car makers, health care systems, insurance companies, banks, credit card companies, retailers, and other systems that are not yours. And most of them also think that data is theirs and not yours.
To collect and manage all that stuff, you need tools that don’t yet exist: tools that are yours and not theirs. We could hardly begin to imagine those tools before AI came along. Now we can.
For example, you should be able to take a picture of the books on your shelves and have a complete record of what those books are and where you got them. You’ll know where you got them because you have a complete history of what you bought, where and from whom. You should be able to point your camera in your closets, at the rugs on your floors, at your furniture, at the VIN number of your car that’s visible under your windshield, at your appliances and plumbing fixtures, and have your AI tell you what those are, or at least make far more educated guesses than you can make on your own.
Yes, your AI should be able to tap into external databases and AI systems for help, but without divulging identity information or other private data. Those services should be dependent variables, not independent ones. For full individual empowerment and agency, you need to be independent. So does everyone else with personal AI.
Now imagine having a scanner that you can feed every bill, every receipt, every subscription renewal notice, and have AI software that tells you what’s what with each of them, and sorts records into the places they belong.
Ever notice that the Amazon line items on your credit card bill not only aren’t itemized, but don’t match Amazon’s online record of what you ordered? Your personal AI can sort that out. It can help say which are business and personal expenses, which are suspicious in some way, what doesn’t add up, and much more.
Your personal AI should be able to answer questions like, How many times have I had lunch at this place? Who was I with? When was it we drove to see so-and-so in Wisconsin? What route did we take? What was that one car we rented that we actually liked?
Way back in 1995, when our family first got on the Internet over dial-up, using the first graphical browsers on our PC, and e-commerce began to take off with Amazon, eBay, and other online retailers, my wife asked an essential question: Why can’t I have my own shopping cart that I take from site to site?
Twenty-nine years later, we still don’t have the answer, because every retailer wants you to use its own. And we’re stuck in that system. It’s the same system that has us separately consenting to what sites ironically call “your privacy choices.” And aren’t.
There are countless nice things we can’t have in the digital world today because we aren’t people there. We are accounts. And we are reduced to accounts by every entity that requires a login and password.
This system is a legacy of client-server, a euphemism for slave-master. We might also call it calf-cow, because that’s how we relate to businesses with which we have accounts. And that model is leveraged on the Web like this:
We go to sites for the milk of content and free cookies, whether we want them or not. We are also just “users.”
In the client-server world, servers get scale. Clients have no more scale than what each account—each cow—separately allows. Sure, users get lots of benefits, but scale across many cows is not one of them. And no, “login with Google” and “login with Facebook” are just passes that let calves of ruling cows wander into vassal pastures.
For individual empowerment and scale to happen, we need to be self-sovereign and independent. Personal AI can give that to us. It can do that by solving problems such as the ones listed above, and by working as agents that represent us as human beings—rather than mere users—when we engage with Big Tech’s cows.
This will be a fight at first, because the cows think they run all of nature and not just their own farms. And $trillions are being invested in the same old cattle industry, with AI painted all over the new barns. Comparatively speaking, close to nothing is going toward giving independent and self-sovereign individuals the kind of power and scale Sam Altman says he wants to give us but can’t because he’s on the big cow side of this thing.
So where do we start?
First, with open source code and open standards. We have some already. Llama 3, from Meta AI, is “your own intelligent assistant,” and positions Meta as a more open and user-friendly cow than OpenAI. Meta is still on the top-down Big Tech side of the war we’re in. But hell, we can use what they’ve got. So let’s play with it.
Here on the ground there are all these (with quotage lifted from their sites or reviews such as this one)—
—and lots of others that readers can tell me about. Do that and I will add links later. This is a work in progress.
Below all of those we still need something Linux-like that will become the open base on which lots of other stuff runs. The closest I’ve seen so far is pAI-OS, by Kwaai.ai, a nonprofit I now serve as Chief Intention Officer. I got recruited by Reza Rassool, Kwaai’s founder and chair, because he believes personal AI is required to make The Intention Economy finally happen. So that was a hard offer to refuse. Kwaai also has a large, growing, and active community, which I believe is necessary, cool, and very encouraging.
As with most (maybe all) of the projects listed above, Kwaai is a grass-roots effort by human beings on the natural, human, and horizontal side of a battle with giants who would rather give us personalized AI than have us meet them in a middle to which we will bring personal AI powers of our own. In the long run, we will meet in that middle, because personal AI will be better for everyone than personalized AI alone.
Watch us prove it. Better yet, join the effort.
*I am indebted to Lavonne Reimer for introducing and co-thinking the horizontal vs. vertical frame, and look forward eagerly to her own writings and lecturings on the topic.
Si l’an passé, la NASA a déclaré 2023 “l’année de l’open source”, elle a toujours fait de l’accès à ses recherches une priorité. Pour faciliter le partage de ses données, la Direction des missions scientifiques (SMD) de la NASA a lancé la version bêta du moteur Science Discovery Engine, optimisée par la plateforme de Sinequa, un leader du marché de la recherche et de l’analyse de données basées sur l’IA.
Cofondé en 2005 par Jean Ferré et Alexandre Bilger, Sinequa permet aux entreprises de tirer de la valeur de la masse de données dont elles disposent. Sa solution, combinant un moteur de recherche puissant (Enterprise Search) avec des fonctionnalités avancées de traitement du Langage Naturel (NLP) et des algorithmes d’apprentissage automatique, permet d’extraire des informations métiers à partir de données structurées, mais également non structurées. La société a été l’une des premières à inclure les grands modèles de langage (LLM) dans la recherche.
Le SDE est un élément clé du programme Open Source Science Initiative (OSSI) de la NASA qui vise à rendre la recherche scientifique financée par des fonds publics transparente, inclusive, accessible et reproductible et de son initiative “Transform to Open Science” (TOPS) dont l’objectif est de créer une culture inclusive de la science ouverte capable de relever les défis du 21e siècle.
En 2019, la communauté scientifique recommandait à la NASA de développer un portail de recherche qui donnerait, à partir d’une seule interface, accès au contenu des cinq domaines scientifiques de la SMD : astrophysique, sciences biologiques et physiques, sciences de la Terre, héliophysique et sciences planétaires.
En 2020, la solution Enterprise Search de Sinequa a été sélectionnée pour aider la NASA à accéder à des informations accumulées depuis plusieurs décennies, ainsi qu’à les exploiter de façon optimale. La collaboration étroite amorcée alors entre l’équipe de Sinequa et les développeurs, chercheurs et data scientists de la NASA a abouti à la création du SDE.
Pour mettre en œuvre ce moteur de recherche, les partenaires ont du relever un défi de taille, outre la quantité des données : leur hétérogénéité et leur complexité, chacun ses 5 domaines opérant avec ses propres normes et terminologies.
Aujourd’hui, les utilisateurs du SDE peuvent extraire des informations enregistrées de plus de 84 000 ensembles de données et plus de 715 000 documents, répartis dans 128 sources d’information différentes, sites internet, référentiels de données et archives documentaires. Egalement intégrée à plus de 44 500 logiciels, modèles et outils scientifiques, la solution de Sequina reconnait plus de 8 900 termes scientifiques différents, un nombre qui devrait augmenter prochainement.
La version bêta du SDE a été lancée en décembre 2022. Depuis lors, l’interface n’a cessé d’être améliorée afin d’offrir des résultats de recherche plus pertinents, une nouvelle version a ainsi été mise en ligne en janvier dernier.
Kaylin Bugbee, chef de projet SDE, explique :
“Les scientifiques et les chercheurs passent beaucoup de temps à rechercher et à démêler des données et des informations scientifiques. Les nouvelles mises à jour de l’interface utilisateur de SDE font gagner du temps aux chercheurs en les aidant à rechercher rapidement des données et de la documentation par sujet scientifique ou dans l’ensemble de la collection d’informations. Cette amélioration de l’efficacité de la recherche permet aux scientifiques d’accéder plus rapidement à une science ouverte et exploitable”.
Désormais, des fonctionnalités de filtrage supplémentaires offrent aux utilisateurs la possibilité d’effectuer des recherches spécifiques dans un domaine scientifique donné, tel que la science planétaire ou l’héliophysique, simplifiant ainsi leurs processus de recherche. Parmi les mises à jour figure également un nouvel outil de recherche par acronyme, permettant une meilleure compréhension du contexte des résultats de recherche et du contenu des documents.
La NASA prévoit d’intégrer davantage de données et de contenus au cours des mois à venir, notamment en enrichissant les fonctionnalités de l’interface utilisateur et en poursuivant le développement de l’API du moteur. L’équipe du SDE prévoit de son côté un déploiement complet de l’outil à l’automne 2024.
Jean Ferré, CEO de Sinequa, conclut :
“Le Science Discovery Engine est une infrastructure fantastique qui aide les scientifiques de la NASA, ainsi que les utilisateurs du monde entier, à trouver les informations dont ils ont besoin en quelques secondes seulement, au lieu de plusieurs minutes, voire de longues heures. Nous sommes fiers d’aider la NASA à transformer et à améliorer la productivité dans l’ensemble de son organisation et serons à ses côtés pour associer de nouveaux ensembles de données et de nouvelles sources d’informations qui alimenteront son moteur de connaissances. Pour la science, la technologie et l’innovation, le partage de données scientifiques et ouvertes constitue le seul moyen de prospérer. À cet égard, Sinequa se réjouit de jouer un rôle actif dans cette initiative”.
Figurez-vous qu’Elektrobit, le géant allemand de l’électronique automobile, vient de nous pondre un truc qui va faire plaisir aux fans de libre : EB corbos Linux, le premier système d’exploitation open source qui respecte les normes de sécurité les plus pointues du monde de la bagnole.
En gros, les constructeurs en ont marre de se trimballer des kilomètres de câbles et des centaines de boîtiers noirs dans leurs caisses-. L’idée, c’est de tout centraliser sur quelques « super ordinateurs » qu’ils appellent des « plateformes de calcul haute performance ». Et chacun gère son domaine : la conduite, l’info-divertissement, les aides à la conduite… Bref, ça simplifie le bordel et ça permet de faire évoluer les fonctionnalités sans toucher au hardware.
Le hic, c’est que tout ce bazar logiciel doit être hyper sécurisé. Parce que si votre autoradio plante, c’est pas bien grave, mais si c’est votre direction assistée qui décide de partir en vacances, bonjour les dégâts ! C’est là qu’EB corbos Linux entre en scène.
Grâce à son architecture unique, ce système d’exploitation prend Linux et le rend compatible avec les exigences les plus draconiennes en matière de sécurité automobile, genre les normes ISO 26262 et IEC 61508 en utilisant un hyperviseur et un système de monitoring externe qui valide les actions du noyau. En gros, Linux peut continuer à évoluer tranquillou sans compromettre la sécurité.
Comme cette distrib est basé sur du bon vieux Linux, il profite de toute la puissance de l’open source. Genre les milliers de développeurs qui bossent dessus, les mises à jour de sécurité en pagaille, la flexibilité, la rapidité d’innovation… Tout ça dans une distrib’ véhicule-compatible, c’est quand même cool. En plus, Elektrobit a développé ce petit miracle main dans la main avec l’équipe d’ingénieurs d’Ubuntu Core chez Canonical. Autant dire que c’est du lourd !
Elektrobit a pensé à tout puisqu’ils proposent même une version spéciale pour les applications critiques, genre les trucs qui peuvent tuer des gens s’ils plantent. Ça s’appelle EB corbos Linux for Safety Applications, et c’est le premier OS Linux à décrocher la certification de sécurité automobile auprès du TÜV Nord.
Mais le plus cool, c’est qu’avec cet OS, vous pouvez laisser libre cours à votre créativité de développeur automobile. Vous voulez intégrer les dernières technos de conduite autonome, d’intelligence artificielle, de reconnaissance vocale… Pas de problème, Linux a tout ce qu’il faut sous le capot.
Imaginez que vous bossiez sur un système de reconnaissance de panneaux pour aider à la conduite. Avec ça, vous pouvez piocher dans les bibliothèques open source de traitement d’image, de machine learning, etc. Vous adaptez tout ça à votre sauce, en respectant les contraintes de sécurité, et voilà ! En quelques sprints, vous avez un truc qui déchire, testé et approuvé pour la route. Et si un autre constructeur veut l’utiliser, il peut, c’est ça la beauté de l’open source !
Autre exemple, vous voulez développer un système de monitoring de l’état de santé du conducteur, pour éviter les accidents dus à la fatigue ou aux malaises. Là encore, EB corbos Linux est votre allié. Vous pouvez utiliser des capteurs biométriques, de l’analyse vidéo, des algorithmes de détection… Tout en étant sûr que votre code ne mettra pas en danger la vie des utilisateurs.
Bref, vous l’aurez compris, c’est le meilleur des deux mondes avec d’un côté, la puissance et la flexibilité de Linux, de l’open source, de la collaboration à grande échelle et de l’autre, la rigueur et la sécurité indispensables au monde automobile, où la moindre erreur peut coûter des vies.


Ce sont les maisons France Services qui ont expérimenté les premières le LLM Albert. Gabriel Attal, en visite dans l’une d’elles à Sceaux, a annoncé ce mardi 23 avril 2024 le prochain déploiement au sein des services publics de ce modèle d’IA souverain, puisque développé par et pour des agents publics français.
Il y a un an, en mai 2023, le gouvernement annonçait une expérimentation visant à mettre l’IA générative au service des agents et usagers du service public, officialisée en octobre suivant par Stanislas GUERINI, Ministre de la Transformation et de la Fonction publiques.
Le mois de septembre précédent, mille agents de la CNAV (Caisse Nationale d’Assurance Vieillesse), Pôle Emploi ou l’Assurance Maladie ont testé un modèle adapté par la start-up française AlloBrain, du LLM Claude d’Anthropic, pour répondre aux commentaires laissés par les usagers sur le site Services-publics.fr.
Les premiers résultats de l’expérimentation, menée par la DITP et la Direction Interministérielle du Numérique (DINUM), se sont avérés très concluants :
La DINUM travaille depuis juin 2023 au développement d’Albert, un modèle interne. En octobre dernier, Ulrich Tan, ingénieur polytechnicien, Chef du pôle Datalab du département Etalab de la Direction interministérielle précisait que ce modèle allait reposer sur “des briques technologiques, des intelligences artificielles pré-entraînées et disponibles en open source”, comme Llama ou Falcon, optimisées grâce au fine-tuning pour les besoins des agents du service public. Les modèles open source de Mistral AI lancés à partir de fin septembre auraient également contribué au développement d’Albert.
Créé par et pour des agents publics, cet outil d’IA générative souverain, libre et ouvert, devait être déployé auprès de conseillers volontaires du réseau France services avant de l’être dans d’autres services publics, ce que vient de confirmer Gabriel Attal :
“Je vous annonce que nous avons développé une intelligence artificielle souveraine, française, qui va révolutionner nos services publics et que nous mettons désormais au service des Français”.
Mentionnant les travaux d’Ulrich Tan et ses collaborateurs au sein du Datalab, il a ajouté :
“Grâce à eux, la France est le premier pays européen à inaugurer une IA 100% souveraine et à la mettre au service de ses services publics”.
Le 7 février dernier, la DINUM a reçu le prix “innovation” lors des Victoires des Acteurs publics, un événement organisé par le média Acteurs Publics sous le haut patronage de la présidence de l’Assemblée nationale, pour le lancement d’Albert.
Chaque mois, les conseillers des 2700 guichets uniques du réseau France Services doivent répondre à près de 800 000 démarches des Français, parfois très complexes.
La version spécifique du réseau “Albert France services”, grâce à un moteur de réponse en langage naturel, leur facilite l’accès aux informations en leur générant une réponse adaptée à la situation de l’usager qu’il accompagne.
Albert fournit au conseiller une réponse rédigée spécifique à la question posée, mais également :
Le conseiller a ensuite la liberté d’utiliser ou non les réponses suggérées ou de les adapter. Comme le souligne le Premier ministre, le but n’est pas de remplacer les agents publics mais de leur permettre de dégager plus de temps pour les relations humaines :
“A l’IA les tâches rébarbatives, et aux agents publics, le lien avec nos concitoyens”.
Vous en avez ras le bol de chercher pendant des heures le bouquin que vous voulez lire sans le trouver dans le commerce ? Pourquoi ne pas le télécharger en ligne alors ? Mais oùùùù ?
Et bien, j’ai peut-être une solution pour vous les amis et ça s’appelle sans chichi ebook-demo, un nouveau projet de moteur de recherche décentralisé pour les livres électroniques, inspiré de Liber3 (qui est un projet aux sources fermées).
Imaginez un peu le truc : vous tapez le titre du livre que vous cherchez dans la barre de recherche, vous cliquez sur « Search » et BAM, les résultats s’affichent juste en dessous avec le titre et l’auteur de chaque bouquin correspondant. C’est simple, efficace et ça marche du tonnerre !
Mais attendez, c’est pas tout. Ce qui rend ce projet encore plus cool, c’est qu’il est basé sur des technologies comme React et le SDK Glitter (pour la blockchain du même nom qui sert de base de données décentralisée).
Bon, je vois déjà les petits malins qui se disent « Ok, c’est bien beau tout ça, mais comment ça s’installe concrètement ?« . Pas de panique, c’est là que ça devient un peu technique mais je vais essayer de vous expliquer ça simplement. Déjà, pour faire tourner ce projet sur votre machine, il vous faudra avoir installé Node.js en version 16.x minimum et npm en version 6.x minimum. Ensuite, vous devrez cloner le dépôt du projet depuis GitHub avec la commande
git clone https://github.com/j2qk3b/ebook-demo
puis vous placer dans le dossier du projet avec
cd ebook-demo
Là, vous lancez un petit
npm install
pour installer toutes les dépendances nécessaires et vous êtes prêt à démarrer le serveur de développement avec
npm run dev
Et voilà, si tout se passe bien, vous devriez pouvoir accéder à l’application sur http://localhost:5173.
Fastoche, non ? Ensuite, votre instance ira se connecter aux autres instances, et vous pourrez faire toutes les recherches qui vous passent par la tête. Imaginez un peu les possibilités offertes par un tel outil. Vous êtes étudiant et vous devez faire des recherches pour un mémoire sur la littérature française du 19ème siècle ? Pas de souci, en quelques clics vous pouvez retrouver les œuvres de Victor Hugo, Balzac ou Zola. Ou alors vous êtes un fan absolu de science-fiction et vous voulez découvrir de nouveaux auteurs ? Là encore, ce moteur de recherche sera votre meilleur ami pour dénicher les pépites du genre.
Mais le plus beau dans tout ça, c’est que ce projet est open source et que tout le monde peut y contribuer. Si vous avez des idées pour améliorer l’outil, des suggestions de nouvelles fonctionnalités ou même si vous voulez corriger des bugs. Puis comme c’est décentralisé, c’est le genre de truc incensurable.
Évidemment, comme tout projet en développement, il y a encore du boulot pour faire de ebook-demo l’outil ultime de recherche de livres électroniques. Mais avec une communauté motivée et des contributeurs talentueux, je suis sûr qu’il peuvent y arriver.
Accrochez-vous à vos claviers, car Meta vient de lâcher dans la nature une nouvelle créature nommée Llama 3. Oui, vous avez bien compris, je parle de la dernière génération de modèles de langage « open source » (ou presque, on y reviendra) de la société de Mark Zuckerberg.
Si vous pensiez que ChatGPT, Claude ou Mistral étaient les rois de la savane, attendez de voir débarquer ces nouveaux lamas survitaminés ! Avec des versions allant de 8 à 400 milliards de paramètres (pour les non-initiés, disons que c’est l’équivalent de leur QI 🧠), les Llama 3 atomisent littéralement la concurrence sur de nombreux benchmarks standards, que ce soit en termes de connaissances générales, de compréhension, de maths, de raisonnement ou de génération de code.
Mais qu’est-ce qui fait de Llama 3 un tel monstre par rapport à son petit frère Llama 2 ? Déjà, un entraînement de folie à base de 15 000 milliards de tokens (7 fois plus que Llama 2 !) pompé depuis le web (!!), avec beaucoup plus de code et de données non-anglaises pour préparer le terrain à une IA multilingue. Ajoutez à ça des techniques de parallélisation à gogo pendant la phase de pré-entraînement, et vous obtenez des lamas dopés qui apprennent à une vitesse supersonique.
Et ce n’est pas tout ! Les Llama 3 ont suivi un programme d’éducation complet, avec du fine-tuning à base de rejection sampling, de PPO et de DPO (si vous ne connaissez pas ces acronymes, ne vous inquiétez pas, moi non plus 😅). Résultat : des modèles ultra-fiables qui refusent rarement une tâche, font preuve d’un alignement exemplaire et sont capables de suivre des instructions complexes sans sourciller. Bref, ce sont des cracks en raisonnement et en génération de code !
Mais au fait, comment on met la main sur ces petites bêtes ? Facile, il suffit de se rendre sur le site de Meta AI et de les télécharger ! Enfin, quand je dis facile… Les Llama 3 sont bien « open source », mais sous une licence maison qui impose quelques restrictions, notamment pour les entreprises de plus de 700 millions d’utilisateurs mensuels (suivez mon regard vers Mountain View et Redmond 👀). Mais bon, rien ne vous empêche de vous amuser avec si vous n’êtes pas une multinationale !
Et en parlant de s’amuser, sachez que Meta a aussi concocté un chatbot maison (pas encore dispo en France) baptisé sobrement « Meta AI« , disponible sur le web (www.meta.ai) et directement intégré dans les barres de recherche de Facebook, Instagram, WhatsApp et Messenger. Sous le capot, c’est bien sûr du pur Llama 3, avec en prime un modèle de génération d’images nommé « Meta Imagine« .
Au programme, de la discussion, de la recherche web via Bing et Google, et bien sûr de la création d’images en un clin d’œil. Seul hic, pas encore de mode multi-modal façon ChatGPT pour uploader vos propres documents ou images, mais ça ne saurait tarder !
Alors, que penser de ce nouveau coup d’éclat de Meta dans la bataille des IA ?
Personnellement, je trouve ça plutôt chouette de voir un poids lourd du Net jouer le jeu de l’open source (ou approchant) et mettre à disposition de tous des modèles de cette qualité. Bien sûr, on peut toujours discuter des arrière-pensées de Zuck et sa volonté de garder un œil sur ce qu’on fabrique avec ses lamas. Mais au final, c’est toujours ça de pris sur les GAFAM et leurs vilains modèles propriétaires !
Allez, je vous laisse, j’ai un lama à aller dompter moi ! 🦙
Et n’oubliez pas, comme le dirait l’autre, « le monde appartient à ceux qui codent tôt ». Ou tard, c’est selon.
Comme attendu, Meta a partagé hier deux premiers modèles de la famille Llama 3 : Llama 3 7B et Llama 3 70B, qui seront suivis dans les prochains mois par des modèles allant jusqu’à 400 milliards de paramètres. Ces deux modèles open source, d’ores et déjà intégrés dans son assistant Meta AI disponible sur ses réseaux sociaux dans certains pays anglophones, sont présentés par Meta comme les meilleurs modèles existants à leur échelle.
Selon la société, les améliorations apportées par rapport à Llama 2 ont considérablement réduit les taux de faux refus, perfectionné l’alignement et accru la diversité des réponses. Llama 3 présente en outre des capacités de raisonnement et de génération de code améliorées.
Meta a comparé les performances de ces modèles dans les benchmarks de référence Llama 3 7B avec Gemma de Google, Mistral 7 B de Mistral AI, et Llama 3 70 B avec Gemini Pro 1,5 de Google et Claude 3 Sonnet d’Anthropic.
L’ensemble de données de pré-entrainement de Llama 3 totalise plus de 15 téraoctets de jetons de données publiques, soit 7 fois plus que celui de Llama 2 et comprend quatre fois plus de code. Pour anticiper les futurs cas d’utilisation multilingues, plus de 5 % de ces données ne sont pas anglaises, couvrant plus de 30 langues. Même si elles sont de haute qualité, Meta reconnaît que les performances dans ces langues peuvent varier par rapport à l’anglais.
Des améliorations ont également été apportées au niveau architecture. Llama 3 utilise un tokenizer avec un vocabulaire de 128 000 jetons qui encode le langage beaucoup plus efficacement. Pour optimiser le processus d’inférence des modèles Llama 3, l’approche d’attention des requêtes groupées (Group Query Attention ou GQA) a été mise en œuvre pour les versions de 8B et 70B. Les modèles ont été entraînés sur des séquences de 8192 tokens, avec l’application d’un masque spécifique assurant que l’attention accordée reste confinée aux frontières du document.
Les deux modèles seront bientôt disponibles sur AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM et Snowflake.
Meta annonce pour les prochains mois plusieurs modèles multimodaux, avec une prise en charge de plusieurs langues, une fenêtre contextuelle plus longue, ainsi que des capacités globales plus robustes. Il donne un aperçu de Llama 3 400B, le plus grand modèle de la famille dont il poursuit l’entraînement.
Les poids de Llama 3 et le générateur de jetons sont téléchargeables sur GitHub.
Accrochez-vous bien à vos slips, parce que je vais vous parler d’un truc de ouf qui risque bien de révolutionner le monde de l’IA portable : Whomane ! Ouais, vous avez bien lu, c’est un projet open source de wearable avec une caméra intégrée.
Whomane, c’est un peu le rêve de tout maker qui se respecte : un appareil portatif bourré d’IA et de capteurs, le tout en mode open source pour pouvoir bidouiller et créer ses propres applications. La vision derrière ce projet, c’est de rendre l’IA embarquée accessible à tous, que ce soit pour l’utiliser ou pour développer dessus.
Concrètement, Whomane se présente sous la forme d’un petit boîtier à clipser sur soi, un peu comme une broche hi-tech. Mais attention, pas n’importe quelle broche ! Celle-là embarque une caméra, un micro et du logiciel capable d’analyser votre environnement en temps réel. Et le tout est propulsé par un raspberry pi Zero capable de faire tourner des modèles de deep learning directement sur l’appareil.
Maintenant, vous vous demandez sûrement ce qu’on peut bien faire avec un truc pareil ? Eh bien, les possibilités sont quasi infinies ! Imaginez par exemple une application qui reconnaît les visages et affiche des infos sur les gens que vous croisez. Ou encore un assistant personnel qui analyse vos conversations et vous souffle des réponses. Vous voyez le genre ?
Mais Whomane, c’est aussi et surtout une plateforme ouverte et collaborative. Le code source est dispo sur GitHub, avec une licence GPL pour les projets open source et une licence commerciale pour ceux qui veulent l’intégrer dans des produits fermés.
Alors okay, je vous vois venir avec vos grands chevaux : « Oui mais la vie privée dans tout ça ? C’est Big Brother ton truc ! » Alors oui, évidemment, dès qu’on parle de caméra et d’IA, ça soulève des questions. Mais justement, l’avantage d’un projet open source comme Whomane, c’est la transparence. Tout est là, à disposition de la communauté pour auditer le code et s’assurer qu’il n’y a pas de dérive. Et puis bien sûr, il faudra toujours veiller à respecter les lois et réglementations en vigueur.
Bref, vous l’aurez compris, Whomane c’est le genre de projet geek et utopiste qui fait vibrer la corde du bidouilleur qui sommeille en nous. Après, on ne va pas se mentir, c’est encore un prototype avec sûrement plein de bugs et de limitations. Mais quand bien même, qu’est-ce que c’est excitant de voir émerger ce genre d’initiatives !
C’est sur X que Mistral AI a choisi d’annoncer Mixtral 8x22B mercredi dernier à l’aide d’un lien magnet Torrent. La jeune licorne n’a pas publié de communiqué de presse ni consacré un blog sur son site à ce dernier modèle, donc on ne sait pour l’instant que peu de choses sur ce nouveau modèle open source mais de premiers benchmarks arrivent sur Hugging Face.
Mistral AI a publié Mixtral 8x7B en décembre dernier, on peut présumer que Mixtral 8x22B en est une version plus performante.
Ces 2 modèles Mixtral 8x sont basés sur une architecture à mélange clairsemé d’experts (SMoE) publiés sous licence Apache 2.0.
En tant que modèle de décodeur exclusivement, Mixtral 8x7B utilise un bloc de rétroaction pour choisir parmi huit groupes distincts de paramètres. À chaque couche et pour chaque jeton, un réseau de routeurs sélectionne deux de ces groupes, appelés “experts”, pour traiter le jeton et combine leur sortie de manière additive.
Cette approche augmente le nombre total de paramètres du modèle tout en contrôlant le coût et la latence. Mixtral 8xB dispose de 46,7 milliards de paramètres au total, mais n’utilise que 12,9 milliards de paramètres par jeton, traitant ainsi les entrées et générant les sorties à la même vitesse et au même coût qu’un modèle 12,9B. Le modèle est pré-entraîné sur des données extraites du Web ouvert, permettant la formation simultanée d’experts et de routeurs.
L’approche a été la même pour Mixtral 8x22B dont le nombre de paramètres peut monter jusqu’à 176 milliards et la fenêtre contextuelle de 65 000 jetons.
Alors que certains voyaient dans le partenariat de distribution que Mistral AI a signé avec Microsoft un abandon de l’open source, la start-up leur prouve qu’il n’en est rien, comme elle l’avait assuré face aux critiques.
Numéricité est un studio des transformations, pour un numérique au service de l’impact et de l’intérêt général. Choisir Numéricité, c’est opter pour une méthode originale qui transforme la transformation (et les organisations).
L’année 2023 a été marquée par une consolidation et une diversification de nos activités.
Nous avons affirmé notre expertise dans la formation et le coaching des équipes projets, l’élaboration de stratégies data, la conception d’ateliers innovants et stimulants, ainsi que le développement de services numériques performants, toujours en conformité avec le RGPD.
Retour sur les moments phares qui ont rythmé cette année.
Numéricité a poursuivi sa croissance et s’est affirmé comme un acteur de la transformation numérique. Pour continuer d’accompagner au mieux les projets de nos clients, huit nouvelles personnes ont rejoint la famille Numéricité. Par ordre d’arrivée :
Notre réseau d’experts s’est renforcé. Mathilde Hoang, Experte en transformation numérique, nous a rejoint en février. Cette collaboration nous permet d’avoir une deuxième implantation internationale, à Hanoï au Vietnam. Nous avons également renouvelé notre collaboration avec Vincent Motte, Chef de projet, et maintenons ainsi notre présence à Abidjan en Côte-d’Ivoire.
Afin d’œuvrer à la réussite des projets de nos clients, nous mettons nos expertises en commun. Celles-ci sont de plus en plus reconnues et demandées. Certains de nos experts sont d’ailleurs référencés par de grandes institutions internationales telles que le FMI ou la Banque Mondiale, et sélectionnés par ailleurs dans le cadre du Collège Numérique France 2030 du Secrétariat général pour l’investissement.
Un pôle communication s’est structuré au sein de Numéricité. Le défi ? Traduire et transmettre les expertises de l’équipe et mieux faire connaitre l’accompagnement 360° que l’on peut proposer qu’il s’agisse de conformité juridique, de développement produit en mode agile ou d’accompagnement en transformation numérique.
Cette année a également été marquée par la poursuite de nos partenariats avec d’autres acteurs de la transformation numérique tels qu’Octo, Nextmap, La Javaness, Hubvisory, Bearing Point, Malt et Opteamis.
Au sein de cet écosystème, nous faisons de notre connaissance fine du numérique public français une force. Plusieurs membres de l’équipe en ont été les forgerons dans une précédente vie professionnelle. En conciliant cela aux méthodes et techniques issues de la culture numérique, nous proposons une approche originale en mesure de donner de nouvelles capacités aux organisations que nous accompagnons.
Ensemble, transformons la transformation numérique pour en faire un levier d’amélioration de vos organisations :
Les entreprises et administrations publiques sont convaincues de la valeur de la donnée qui est un actif stratégique pour l’ensemble de l’organisation et pas seulement pour un seul service ou une direction métier. C’est pourquoi les entreprises et les administrations publiques se transforment afin de mieux valoriser ces données et investissent dans la construction et la mise en place d’une stratégie data au service de leur stratégie globale.
Nous appuyons cette transformation à travers la co-construction de stratégies data portant sur l’ouverture des données, la modernisation des SI afin de les orienter vers une meilleure circulation de la donnée, et construisons des produits data à destination des métiers. Nous intervenons ainsi dans des secteurs à l’impact quotidien : les mobilités, la santé, le logement, le travail, l’inclusion, l’environnement, la fiscalité, les douanes, etc.
Nous réinterrogeons et transformons les organisations à travers une meilleure prise en compte des données au service de l’impact : c’est une des traductions concrètes de notre offre Transfo-soft.
Afin de faciliter la vie des usagers, citoyens comme entreprises, notre pôle Intelligence juridique et conformité a appuyé l’ouverture des données, comme celles produites par France Chaleur Urbaine ou MaCantine.
Moderniser les SI est un prérequis pour faciliter la circulation de la donnée. Pour cela, nous proposons une expertise d’audit nous permettant de formuler des recommandations d’actions concrètes. L’objectif est d’engager la transformation par les métiers, en améliorant leur process internes ou leur organisation produit par exemple.
Nous avons accompagné de nombreux acteurs, territoires et gouvernements dans la concertation, la construction et la priorisation de leurs stratégies data. Un seul impératif : mettre l’humain, que ce soit les métiers, les acteurs économiques et/ou les usagers au cœur de la réflexion.
Pour embarquer ces différents collectifs, qu’ils soient spécialistes ou non de la data, nous disposons d’un large éventail de formats : open-lab, ateliers, entretiens, expérimentations, cas d’usage, datadays, hackathons. Il s’agit là d’une première brique de notre approche produit des stratégies data, visant ensuite à s’interroger sur les données à mobiliser, la gouvernance à constituer, les compétences à renforcer, avant de réaliser des expérimentations à petite échelle pour confirmer les orientations.
Ces missions ont largement ponctué notre activité en 2023. Voici quelques exemples emblématiques :
Nous suivons la même méthode produit dans la conception de services numériques appuyés sur des données. 2023 a été marquée par la conception de 10 produits numériques par notre Pôle design et technologies.
Par exemple, avec La Fabrique des ministères sociaux et l’ARS Île-de-France, nous avons conçu et développé un outil de datavisualisation des causes médicales de décès, s’appuyant sur quelques 315K certificats de décès franciliens émis depuis 2020 et l’industrialisation d’un flux de données de l’INSERM.
Nous avons également accompagné l’Agence Nationale d’Information sur le Logement (ANIL) dans l’élaboration d’une base de données partagée avec ses relais départementaux, afin de faciliter le partage d’informations au sein du réseau. AdilStatWeb2 a été consulté 815 000 fois et une interface de croisement des données a été créée.
La démocratisation des intelligences artificielle génératives (IAG) est en train de bousculer nos pratiques à une vitesse fulgurante. Avec ces avancées, viennent des défis complexes en matière de sécurité, de responsabilité et de protection des droits fondamentaux.
Pour en savoir plus sur l’encadrement législatif de l’intelligence artificielle, (re)découvrez nos derniers articles de décryptage :
Écoutez notre podcast sur la régulation du numérique par le législateur avec Éric Bothorel, député de la 5e circonscription des Côtes-d’Armor :
En interne, nous mobilisons plusieurs outils d’IAG (ChatGPT, MidJourney et Copilot) pour gagner en maîtrise et en efficacité tout en explorant les fonctionnalités pour de futures missions. Nous sommes d’ailleurs en train d’entraîner un NuméricitéGPT, connecté à OpenAI et basé sur le scraping des contenus de notre site, pour répondre à des besoins de communication et de partage des savoirs en interne.
Dans le cadre de nos missions, nous nous sommes particulièrement intéressés au domaine des agents conversationnels appuyés sur de grands modèles de langage (Large Language Model ou LLM). Ces innovations nous ont permis de développer des solutions adaptables, qui garantissent la protection des données exploitées.
Nous avons entraîné un modèle basé sur le LLM Mistral pour expérimenter l’usage d’un agent conversationnel sur des questions de santé sexuelle. Pour répondre, l’agent s’appuie sur des contenus web scrapés sur différents sites officiels.
Nous avons prototypé deux agents conversationnels connectés à OpenAI grâce à une clé d’API. L’hébergement de ces bots sur nos serveurs garanti la souveraineté en assurant qu’aucune données fiscales sensibles ne soient transmises à OpenAI. Grâce à ces bots, les agents de la Direction Générale des Impôts (DGI) de Mauritanie acquièrent de l’autonomie dans leurs tâches quotidiennes en pouvant générer de manière automatisée des rapports d’analyse des indicateurs issus de leur tableau de bord (bot Reporter) et interroger directement leurs jeux de données (FileBot).
Notre pôle Intelligence juridique et conformité participe à déterminer et maîtriser les impacts de l’IA dans l’administration. Cela l’a conduit à élaborer différents guides de bonnes pratiques. Avec La Javaness, nous avons accompagné Pôle Emploi afin de confronter l’offre de service de la plateforme IA aux différents usages, afin d’en adapter le contenu et inscrire ce produit et les services associés dans un processus d’amélioration. L’enjeu était de créer un socle IA du service public de l’emploi qui soit un gage de souveraineté et d’efficacité pour la puissance publique.
Numéricité prône une approche 360° de la conformité : nos missions s’articulent entre la protection de la vie privée et la circulation des données. Nous intervenons tant à l’échelle d’un projet qu’à l’échelle d’une organisation et proposons pour cela une conception agile de la conformité. Pour cela, nous travaillons au plus près des équipes, en leur proposant de nombreux formats adaptés à leurs besoins, que ce soit des cliniques, des formations, des stands ou du question/réponse via messagerie instantanée.
Nous avons accompagné la conformité d’acteurs de toutes tailles, publics comme privés, dont plus d’une centaine de Startups d’État.
Nous avons pu également administrer un premier audit “blanc” à l’Unédic, inspiré des audits de certification appliqués par la CNIL, afin de formuler des recommandations et des corrections.
Chez Numéricité, nous avons l’open source chevillé au corps (et au cœur). Dans l’ensemble de nos projets, nous nous efforçons de mettre en place ou orienter nos clients vers des solutions open source.
Par exemple, nous avons déployé Onyxia afin de permettre aux agents de quatre pays d’Afrique de l’Ouest partenaires du projet DATAFID de se former et s’entraîner à la datascience avec pour objectif d’améliorer les recettes fiscales et douanières. Pour en savoir plus sur Onyxia, et plus largement sur le projet DATAFID.
Nos convictions dans les communs se sont aussi traduites par notre participation à la sixième édition de Numérique en Commun[s]. À cette occasion, nous avons pu proposer deux ateliers sur la conception de produits data avec et pour des utilisateurs non spécialistes de la donnée, et sur le RGPD comme accélérateur des projets. Nous avons également accompagné l’Institut national de l’information géographique et forestière (IGN), partenaire de l’évènement, dans la conception et l’éditorialisation de ses formats.
Vivez notre aventure à Numérique en Commun[s] et découvrez les cinq principes d’action pour développer des produits data avec et pour des utilisateurs non spécialistes de la donnée issus de l’atelier :
Cette rétrospective de nos activités en 2023 serait incomplète sans parler nos interventions à l’international et notre expertise e-gov. Nous intervenons actuellement dans 15 pays.
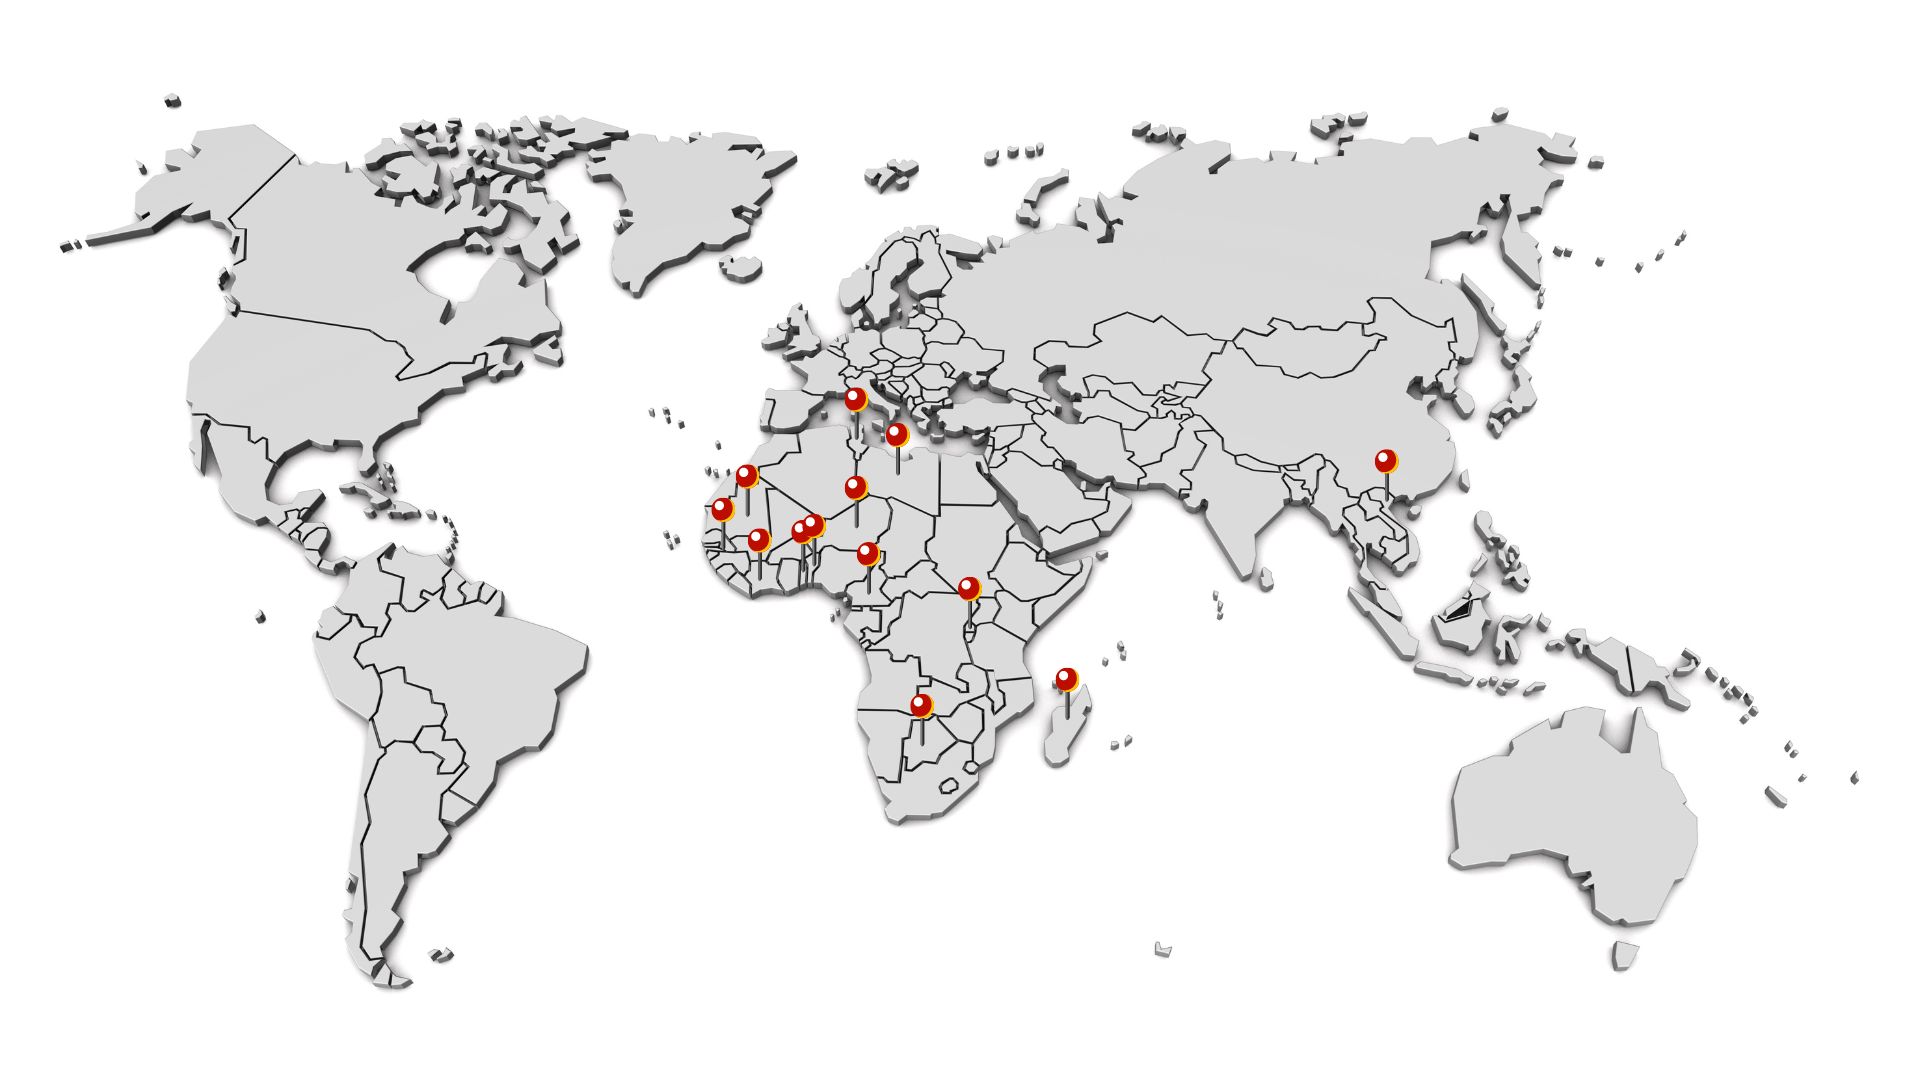
Nos interventions e-gov sont au croisement de l’ensemble de nos expertises.
Nos experts référencés par le Fonds Monétaire International (FMI) ont par ailleurs appuyé la réalisation d’études préparatoires au Cameroun et en Tunisie.
Pour en savoir plus sur notre accompagnement de la Libye dans l’appréhension des enjeux de la transformation numérique
2023 a été une année de succès, d’innovation et d’impact pour Numéricité. Nous nous imposons comme un acteur de l’écosystème de la transformation numérique, tout en y apportant notre touche d’originalité.
Nous continuons de transformer la transformation numérique avec une équipe talentueuse d’experts et des projets ambitieux, en portant une attention particulière à l’impact et à l’éthique.
Pour en découvrir davantage sur notre méthode et envisager de nouveaux projets ensemble, contactez-nous : contact@numericite.eu
Figurez-vous que le géant Microsoft, oui oui, le monstre de Redmond, se retrouve à genoux devant la communauté open source de FFmpeg.
Et pourquoi donc ? Parce que ces satanés codecs multimédias leur donnent du fil à retordre !
Mais attention, ne croyez pas que Microsoft va gentiment demander de l’aide comme tout le monde. Non non non, eux ils exigent, ils ordonnent, ils veulent que les petites mains de FFmpeg réparent illico presto les bugs de leur précieux produit Teams. Bah oui, faut pas déconner, c’est pour un lancement imminent et les clients râlent !
Sauf que voilà, les gars de FFmpeg ils ont pas trop apprécié le ton. Ils sont là, tranquilles, à développer leur truc open source pour le bien de l’humanité, et là Microsoft débarque en mode « Eho les mecs, faudrait voir à bosser un peu plus vite là, on a besoin de vous là, maintenant, tout de suite ». Super l’ambiance.
Alors ok, Microsoft a daigné proposer quelques milliers de dollars pour les dédommager. Mais bon, les développeurs FFmpeg ont un peu de fierté quand même et souhaitent un vrai contrat de support sur le long terme, pas une aumône ponctuelle balancée comme on jette un os à un chien.
Et là, c’est le choc des cultures mes amis ! D’un côté Microsoft, habitué à régner en maître sur son petit monde propriétaire, à traiter les développeurs comme de la chair à code. De l’autre, la communauté open source, des passionnés qui bouffent du codec matin midi et soir, qui ont la vidéo dans le sang et le streaming dans les veines.
Microsoft fait moins le malin maintenant puisqu’ils réalisent que leur précieux Teams, ça marche pas terrible sans FFmpeg et que leurs armées de développeurs maison, n’y connaissent pas grand chose en codecs multimédia. Et surtout que la communauté open source, bah elle a pas trop envie de se faire exploiter comme ça.
Moralité de l’histoire : faut pas prendre les gars de FFmpeg pour des poires. Ils ont beau être « open », ils ont leur dignité et Microsoft va devoir apprendre à respecter ça, à collaborer d’égal à égal, à lâcher des billets et des contrats de support au lieu de jouer au petit chef.
Parce que sinon, Teams risque de sonner un peu creux sans codecs qui fonctionnent. Et là, ça va être dur d’expliquer aux clients que la visio ça sera en version mime, parce que Microsoft a pas voulu mettre la main au portefeuille pour avoir de l’audio qui marchent.
Et, si vous voulez en savoir plus sur ce choc des titans, foncez sur https://sopuli.xyz/post/11143769 , vous n’allez pas être déçu du voyage !
Vous aimez créer des stickers pour épater vos amis sur les réseaux sociaux ? Mais vous en avez marre de passer des heures sur Photoshop pour un résultat pas toujours au top ? J’ai ce qu’il vous faut !
Le site web StickerBaker est une vraie petite pépite pour générer des stickers personnalisés en quelques clics grâce à l’intelligence artificielle.
Concrètement, vous uploadez une photo de votre trombine, vous entrez une petite description façon prompt et bim, l’IA vous génère un sticker sur-mesure avec un rendu digne des plus grands graphistes. Pas besoin d’être un crack en dessin ou en retouche d’image, StickerBaker s’occupe de tout !
Mais alors StickerBaker, ça peut servir à quoi concrètement ? Et bien comme je le disais, créer des stickers complètement barrés à partir de vos photos pour amuser la galerie et mettre l’ambiance dans la conversation WhatsApp du jeudi soir ! Mais ça peut aussi permettre à des artistes, graphistes ou même des marques de prototyper rapidement des designs de stickers avant une prod plus poussée. Plutôt que de partir d’une feuille blanche, autant utiliser l’IA pour générer des premiers jets et itérer à partir de là. Ça peut faire gagner un temps fou.
Sous le capot, le site utilise le modèle Albedo XL et des techniques de machine learning comme les LoRA (Learning Rate Adaptation) pour comprendre votre prompt et générer un visuel qui déchire. Les plus geeks d’entre vous apprécieront les performances de l’engin : un sticker généré en 10 secondes max grâce aux cartes graphiques Nvidia A40. Ça envoie du lourd !
Et le must du must, c’est que StickerBaker est un projet open source, le code est dispo sur GitHub. Ça veut dire que la communauté peut mettre la main à la pâte pour améliorer l’outil. Vous pouvez par exemple bidouiller le code pour modifier les styles de stickers générés. Un vrai bonheur pour les devs qui veulent comprendre comment ça marche derrière.
Autre bon point, vos photos sont supprimées direct après le traitement. Pas de stockage chelou des données ou d’utilisations douteuses derrière, StickerBaker est clean de ce côté là. C’est toujours appréciable de nos jours.
Après, faut pas se leurrer, on est encore loin d’une app grand public. L’interface est rudimentaire et il faut un minimum biberonné à l’anglais et à l’univers des IA générative pour pas être largué. Mais c’est un premier pas encourageant vers la démocratisation de ces technologies.
Au final, StickerBaker c’est une chouette démo techno qui montre tout le potentiel de l’IA générative appliquée au domaine des stickers et du graphisme. Le projet n’en est qu’à ses débuts mais mérite clairement d’être suivi de près. Ça pourrait bien révolutionner notre manière de créer des visuels à l’avenir, qui sait ? En tout cas, moi j’ai hâte de voir les prochaines évolutions de ce genre d’outils !
Merci à Lorenper pour l’info.
Elon Musk avait annoncé la semaine dernière que Grok, le chatbot IA développé par sa startup xAI, serait désormais open source. C’est chose faite : les poids du modèle de fondation qui l’alimente, Grok-1, ainsi que son architecture ont été publiés hier sur GitHub. Il est également possible de retrouver les poids du modèle depuis ce matin via un fichier torrent sur X.
En juillet dernier, Elon Musk annonçait le lancement de xAI, qui avait été enregistrée au Nevada le mois de mars précédent. Onze experts en IA, travaillant auparavant chez DeepMind, OpenAI, Google Research, Microsoft Research, Tesla et l’Université de Toronto, étaient venus complétés son équipe, basée en Californie.
Elon Musk affirmait que Grok était la meilleure IA générative existant alors, soulignant que “Grok a accès en temps réel aux infos via X, ce qui lui donne un avantage majeur sur les autres modèles”. Le chatbot est disponible depuis fin 2023 pour les abonnés X Premium+, sensé leur répondre avec humour et sans filtre.
Sur son blog, XAI explique que la version de Grok publiée en open-source, est un modèle de mélange d’experts (MoE) de 314 milliards de paramètres formé à partir de zéro. Il s’agit du point de contrôle du modèle de fondation brut de la phase de pré-formation Grok-1, qui s’est terminée en octobre 2023, ce qui signifie que le modèle n’est pas affiné pour une application spécifique, telle que le dialogue.
Il a été publié sous licence Apache 2.0, les développeurs peuvent donc le modifier et le redistribuer à leur gré.
Lorsqu’Elon Musk a cofondé OpenAI en 2015 avec notamment Sam Altman, c’était en tant qu’organisation à but non lucratif visant à développer des intelligences artificielles générales bénéfiques à l’humanité. Sa charte stipule : “Nous tenterons de construire directement des AGI sûres et bénéfiques, mais considérerons également notre mission comme remplie si notre travail aide les autres à atteindre ce résultat”.
Elon Musk, qui l’a quitté en 2018, a déposé plainte début mars contre OpenAI et Sam Altman pour non-respect de l’accord initial à l’origine de la création de l’association, GPT-4 étant un modèle fermé. Elon Musk s’est alors vu reprocher une certaine ambivalence et hypocrisie du fait que Grok l’était aussi. Le 11 mars dernier, il a donc annoncé l’ouverture du modèle.
Le 7 mars dernier, lors du Confiance.ai Day 2024, le collectif a annoncé l’ouverture aux communautés scientifiques et industrielles de la méthodologie mise au point ainsi que des composants open source associés. Alors que le programme doit s’achever cette année, les partenaires ont décidé de se concentrer sur l’approfondissement, la pérennisation et l’industrialisation des résultats obtenus. Ils ont également l’intention de créer une fondation afin de fédérer un ensemble d’acteurs à l’échelle internationale autour d’une feuille de route commune.
Confiance.ai, le plus gros programme de recherche technologique du plan #AIforHumanity, est une initiative majeure qui vise à renforcer le leadership technologique des entreprises françaises dans le domaine de l’IA industrielle. Lancé en 2021 dans le cadre de la Stratégie nationale pour l’intelligence artificielle financée par France 2030, il s’est concentré sur le développement d’une méthodologie de bout en bout et d’une série de composants technologiques open source pour intégrer des IA de confiance dans des systèmes industriels critiques, accessibles sur https://bok.confiance.ai/.
La méthodologie développée offre un guide complet, permettant aux industriels de caractériser et de qualifier la confiance des systèmes intelligents dirigés par les données, et ce, dans n’importe quel secteur d’activité.
Ses 126 composants ont été regroupés en neuf ensembles fonctionnels correspondant à des processus d’ingénierie bien précis : ingénierie de bout en bout, gestion du cycle de vie de la donnée, gestion du cycle de vie des modèles et des composants, évaluation des composants d’IA, déploiement des composants IA, gestion des systèmes d’IA en opération, robustesse, explicabilité et quantification de l’incertitude.
Des secteurs clés tels que l’automobile, l’aéronautique, l’énergie et la défense ont déjà bénéficié des avancées de Confiance.ai. Des entreprises du collectif ont mis en œuvre ces nouvelles méthodologies : elles ont permis à Air Liquide d’améliorer la précision des modèles d’IA pour la gestion de l’inventaire, à Thales de valider et de monitorer les performances des algorithmes de détection d’objets, et à Renault Group de vérifier la qualité des soudures sur ses véhicules.
Précurseur dans le domaine de l’IA de confiance, en plus de son impact sur l’industrie française, Confiance.ai joue un rôle moteur dans la construction d’un écosystème mondial de l’IA de confiance, en établissant des partenariats avec des initiatives similaires à l’étranger. Il a notamment signé un MoU (Memorandum of Understanding) avec le programme Confiance IA au Québec et en Allemagne avec VDE, l’une des plus importantes organisations technologiques d’Europe.
Juliette Mattioli, Présidente du comité de pilotage de Confiance.ai et Expert sénior en Intelligence Artificielle chez Thales, commente :
“Nous nous sommes attaqués à une problématique particulièrement complexe et ambitieuse. Les résultats obtenus sont en ligne avec nos objectifs et remarquables à plusieurs égards. Tout d’abord, sur le plan humain, nous sommes parvenus à faire collaborer un écosystème hybride composé d’industriels, de scientifiques, de data scientists, d’ingénieurs, etc. Nous avons également relevé un grand nombre de défis scientifiques et technologiques – plus que nous l’avions imaginé – et nous avons été moteur dans de nombreuses d’initiatives au niveau international. Une véritable communauté mondiale autour de l’IA de confiance est en train d’émerger”.
Alors que le programme Confiance.ai se terminera fin 2024, les partenaires se projettent déjà vers l’avenir. Leurs ambitions se concentrent sur trois axes principaux : approfondir, pérenniser et industrialiser.
Fabien Mangeant, Président du comité de direction de Confiance.ai et Directeur Scientifique Digital d’Air Liquide, explique :
“Il reste encore de nombreux défis scientifiques et technologiques à relever pour que la France maintienne son avance dans le domaine et nous sommes en train de les répertorier. Les sujets du transfert et de la valorisation de nos travaux sont des chantiers prioritaires, tout comme la résolution de nouveaux verrous scientifiques et technologiques”.
Les partenaires du programme ont identifié plusieurs problématiques pour lesquelles il serait opportun de lancer de nouveaux projets de recherche et technologie (R&T), notamment l’IA hybride, les IA génératives telles que le LLM, et la cybersécurité des IA intégrées aux systèmes critiques. Ces nouveaux projets R&T enrichiront les méthodes existantes en les adaptant à de nouveaux domaines d’application.
Un autre objectif majeur est la pérennisation et la diffusion de la méthodologie développée. Cela passe par son ouverture et par le lancement d’une initiative de fondation visant à rassembler des acteurs du monde entier autour d’une feuille de route commune. Cette fondation contribuera à maintenir ce “bien commun numérique” opérationnel et à le faire évoluer grâce aux retours d’expérience et aux propositions d’amélioration. De plus, la formation, notamment à travers le Mastère Spécialisé sur l’IA de Confiance co-conçu avec CentraleSupélec, jouera un rôle essentiel dans l’élévation de la maturité de cette méthodologie.
Enfin, la troisième ambition est l’industrialisation des résultats du programme afin de les rendre utilisables à grande échelle par les ingénieries des entreprises. Cette démarche vise à créer et à mettre à disposition des outils de compétitivité adaptés aux spécificités de chaque entreprise en matière de typologie, de données et de cas d’usage.
Le marché des robots humanoïdes devrait atteindre 8 milliards de dollars d’ici 2030, ce qui explique l’intérêt dans ce secteur des grandes firmes ou de start-ups comme OpenAI qui s’est associé en mars 2023 avec 1X Technologies pour développer NEO, un robot humanoïde alimenté par l’IA. Selon un post de Remi Cadene sur X, Hugging Face se lancerait lui aussi dans un projet robotique, mais open source.
Passée au rang de licorne après une levée de fonds de 235 millions de dollars en août dernier, Hugging Face, start-up créée à Paris en 2016 mais également basée à New York, se positionne comme une alternative open source à OpenAI. Elle a présenté HuggingChat, comme une alternative open source à ChatGPT et ses Hugging Face Assistants, gratuits et eux aussi open source, lancés il y a un mois, rivalisent avec les GPT du Store d’Open AI.
Ce qu’appuie Remi Cadene dans son post sur X :
“Après 3 ans @tesla et Optimus, je suis ravi d’annoncer que j’ai rejoint Hugging Face pour lancer un ambitieux projet de robotique ouverte ! (open comme dans open-source, pas comme dans Open AI) A la recherche d’ingénieurs pour construire de vrais robots à Paris.”
After 3 years @tesla and Optimus, I am thrilled to announce that I joined Hugging Face to start an ambitious open robotics project! (open as in open-source, not as in Open AI) Looking for engineers to build real robots in Paris 🇫🇷 https://t.co/cFuNL4PVI4 🤖🤗 pic.twitter.com/7IkunPXOpX
— Remi Cadene (@RemiCadene) March 7, 2024
Sur son site, on peut lire :
“Je construis des robots de nouvelle génération chez Hugging Face. Auparavant, j’étais chercheur scientifique chez Tesla sur Autopilot et Optimus. Sur le plan académique, j’ai fait des études postdoctorales à l’Université Brown et mon doctorat à la Sorbonne”.
Si Hugging Face n’a pas confirmé pour l’instant, le lien publié renvoie vers une offre d’emploi d’ingénieur en robotique incarnée à Paris. La start-up y stipule :
“Chez Hugging Face, nous pensons que le ML ne doit pas nécessairement se limiter aux ordinateurs et aux serveurs, et c’est pourquoi nous élargissons notre équipe avec une nouvelle opportunité pour un ingénieur en robotique axé sur l’apprentissage automatique/l’IA.
Dans ce rôle, vous serez responsable de la conception, de la construction et de la maintenance de systèmes robotiques open source et à faible coût qui intègrent les technologies d’IA, en particulier dans l’apprentissage profond et l’IA incarnée. Vous collaborerez en étroite collaboration avec les ingénieurs ML, les chercheurs et les équipes de produits pour développer des solutions innovantes qui repoussent les limites de ce qui est possible en robotique et en IA”.
Hugging-Face-projet-robotique-open-source